Agile Deliberation

2周前发布 24 00

Google Research 推出 Agile Deliberation,一套用于灰色地带、主观概念图像分类的人在环路审议框架,已被 CVPR 2026 接收。它适合 “健康食品”“标题党(paid to play)” 这类边界模糊、没有标准答案的概念;区别于传统方案 —— 它不要求使用者预先清楚概念边界,而是辅助人一起探索、收敛边界定...
所在地:
Google AI Research
收录时间:
2026-11-05
Agile DeliberationAgile Deliberation

Google AI Research发布了 Agile Deliberation,这是一个专为处理“灰色地带”(主观或模糊概念,如“健康食品”、“标题党”或特定艺术风格)而设计的人在环路(Human-in-the-Loop, HITL)图像分类框架。该框架不依赖传统的静态标注,而是通过人机协作动态探索并界定概念的语义边界,最终生成结构化的文本定义以驱动视觉语言模型(VLM)。
Agile Deliberation

核心机制与技术亮点

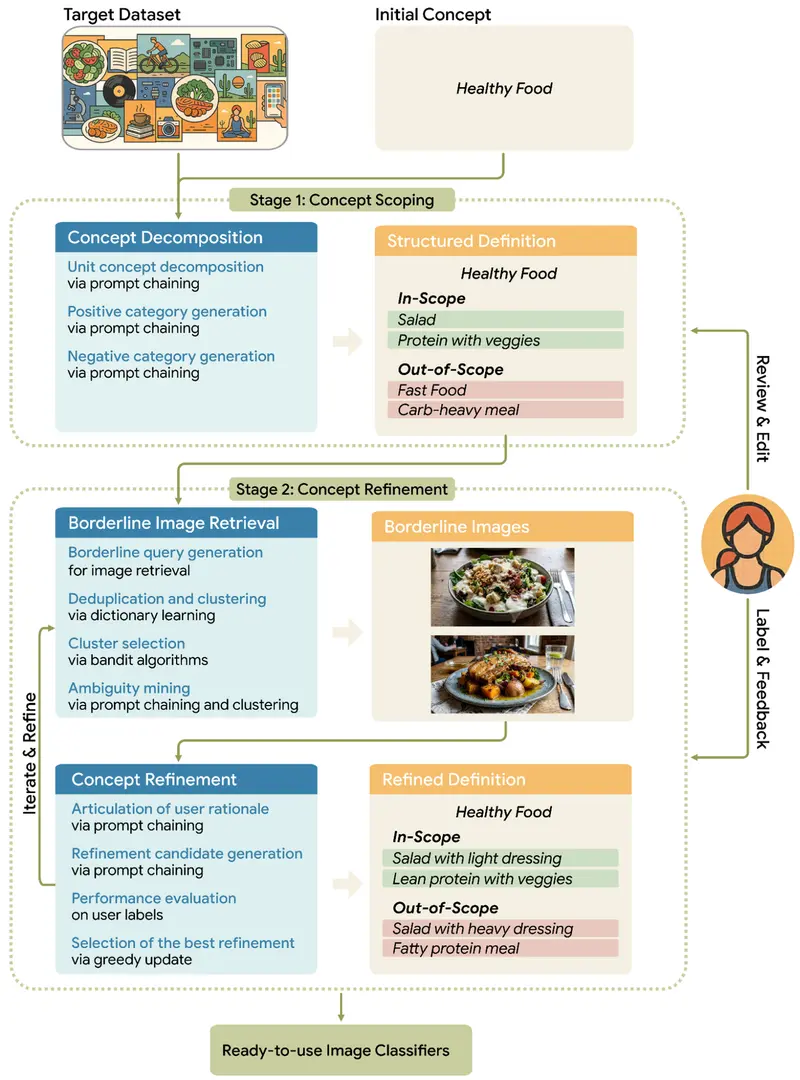
Agile Deliberation 的核心创新在于按语义含义而非模型置信度来寻找边界图像,从而克服了生成式 VLM 置信度分数通常未校准的问题。其工作流分为两个关键阶段:

  1. 概念分解与初步界定(阶段 1):
    利用 Gemini 2.5 Pro 的提示链,将宏观的模糊概念拆解为最多 3 个单元概念。系统为每个单元提供候选的正/负子概念及检索到的图像,由用户进行保留、翻转或丢弃,建立初步的认知基线。
  2. 语义边界探索与动态优化(阶段 2):
    摒弃传统的不确定性采样,系统通过以下 4 步主动寻找最具信息量的“边界图像”:

    • 边界查询生成:Gemini 2.5 Flash 自动生成针对模糊地带的查询(如“淋了大量蛋黄酱的沙拉”),并检索 50-100 张图像。
    • 聚类与去重:对图像进行编码,并通过字典学习将其分组为语义簇。
    • 智能采样:使用 UCB(Upper Confidence Bound)多臂老虎机算法,优先选择用户曾纠正过模型或能提供丰富反馈的高价值簇。
    • 歧义总结与定义更新:VLM 用一句话总结簇内图像的共享歧义。用户标记图像并添加简短笔记,LLM 将这些反馈转化为新的候选定义,并通过贪婪更新策略保留 F1 得分最高的定义。

性能表现与评估

由于主观概念缺乏固定的“Ground Truth”,Google 团队采用了 18 次实时会话(每次约 90 分钟,由 9 名非专业参与者完成)进行动态评估,对比了“Paid to play(标题党)”和“健康食品”两个概念:

  • 显著的性能提升:Agile Deliberation 组的平均 F1 分数比零样本(Zero-shot)Gemini 2.5 Flash 高出 10.5 个百分点。
    • Paid to play:F1 从 0.48 提升至 0.59(精确率大幅提升 22 点)。
    • 健康食品:F1 从 0.48 提升至 0.58。
  • 效率与体验优化:参与者报告称,相较于手动提示词编辑,该方法显著降低了认知努力与操作压力,仅需约 45 分钟即可完成概念定义与 200 张留测图像的标注。

部署环境与开发者支持

  • 轻量级运行环境:框架无需微调模型,完全通过 API 调用 Gemini 2.5 Pro/Flash 实现。检索模块基于 CLIP 嵌入和 FAISS 索引,可在 CPU 或 GPU 上运行。
  • 快速上手:官方 GitHub 仓库(Apache 2.0 许可)提供了 Demo.ipynb。演示环境仅需下载约 260 MB 的 FAISS 索引分片(完整 100 个分片约 13 GB),配置 Gemini API 密钥即可在 Jupyter 或 Colab 中复现“健康食品”的完整界定流程。
相关导航

Cua-S1

Cua-S1

cua-s1-forms 是一款轻量、对标 Jev(System One)的单遍选项评分模型,定位为 GUI 表单自动填写场景下的决策层,作为 cua-driver 的底层决策核心。它和常规自回归大语言模型存在本质差异:**不输出文本**。输入 UI 界面元素、带类型的候选选项集合(每条实体对应一个选项,额外包含勾选 / 点击 / 跳过动作),模型仅通过一次前向传播输出各个选项的概率,输入输出接口契约和 TypeSafe 的 Jev 保持一致。