Littlebird
Littlebird不存储任何截图或视觉数据,仅通过读取电脑屏幕内容,将核心信息转化为文本格式留存。该产品核心逻辑为:后台静默运行读取屏幕,无需额外补充上下文即可为用户提供生产力辅助,区别于多数主动打扰用户的AI工具,仅在用户需要时响应,全程不干扰正常办公使用。
Tile Language 是一种简洁的领域特定语言,旨在简化高性能 GPU/CPU 内核的开发(例如 GEMM、Dequant GEMM、FlashAttention、LinearAttention)。通过采用 Pythonic 语法和基于 TVM 的底层编译器基础设施,tile-lang 允许开发人员专注于生产力,同时不牺牲实现最先进...
 TileLang (tile-lang)
在 AI 大模型时代,高性能算子(如 GEMM、FlashAttention)是决定推理速度的关键。然而,传统的手写 CUDA/Triton 内核不仅开发门槛高,且难以在不同硬件间移植。
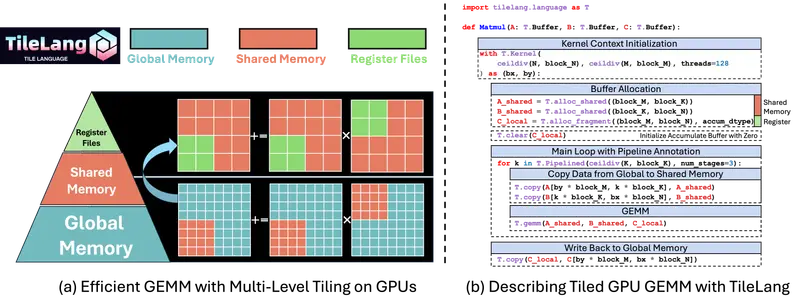
TileLang (tile-lang) 是一种简洁的领域特定语言(DSL),通过 Pythonic 语法 和基于 TVM 的强大编译器基础设施,简化高性能 GPU/CPU 内核的开发。它让开发者能够专注于算法逻辑,同时自动完成底层优化,实现媲美手工汇编的性能。
TileLang 允许你用类似 Python 的代码描述复杂的并行计算、内存布局和流水线策略。
TileLang 致力于跨平台移植,目前已验证支持:
提供构建各种复杂算子的基石,包括:
TileLang 社区活跃,近期更新频繁:
apache-tvm-ffi,显著降低 CPU 开销。以下代码展示了如何使用 TileLang 编写一个带有 ReLU激活、共享内存优化和流水线并行的矩阵乘法内核。
import tilelang as T
import torch

# @tilelang.jit 装饰器自动处理编译和缓存
# target 可指定为 "cuda", "hip", "cpu" 等,默认根据输入推断
@tilelang.jit
def matmul_relu(
    A, B,
    block_M: int = 64,
    block_N: int = 64,
    block_K: int = 64,
    dtype: T.dtype = T.float16,
    accum_dtype: T.dtype = T.float32,
):
    # 声明编译时常量
    M, N, K = T.const('M, N, K')

    # 标注输入张量形状
    A: T.Tensor[[M, K], dtype]
    B: T.Tensor[[K, N], dtype]

    # 分配输出张量
    C = T.empty([M, N], dtype)

    # 定义 Kernel 网格和线程块
    with T.Kernel(T.ceildiv(N, block_N), T.ceildiv(M, block_M), threads=128) as (bx, by):
        # 分配共享内存和局部寄存器片段
        A_shared = T.alloc_shared((block_M, block_K), dtype)
        B_shared = T.alloc_shared((block_K, block_N), dtype)
        C_local = T.alloc_fragment((block_M, block_N), accum_dtype)

        # 【可选】启用 Swizzle 以优化 L2 缓存局部性
        # T.use_swizzle(panel_size=10, enable=True)

        # 清空局部累加器
        T.clear(C_local)

        # 流水线循环,num_stages=3 实现重叠计算与数据传输
        for ko in T.Pipelined(T.ceildiv(K, block_K), num_stages=3):
            # 并行拷贝 A 的分块到共享内存
            T.copy(A[by * block_M, ko * block_K], A_shared)
            # 并行拷贝 B 的分块到共享内存
            T.copy(B[ko * block_K, bx * block_N], B_shared)

            # 执行_tile_级别的 GEMM (底层调度至 CuTe/HIP)
            T.gemm(A_shared, B_shared, C_local)

        # Element-wise ReLU 激活
        for i, j in T.Parallel(block_M, block_N):
            C_local[i, j] = T.max(C_local[i, j], 0)

        # 将结果从局部内存拷贝回全局内存
        T.copy(C_local, C[by * block_M, bx * block_N])

    return C

# --- 测试与验证 ---
M, N, K = 1024, 1024, 1024
a = torch.randn(M, K, device="cuda", dtype=torch.float16)
b = torch.randn(K, N, device="cuda", dtype=torch.float16)
c_ref = torch.relu(a @ b)

# 直接调用 JIT 编译后的函数
c = matmul_relu(a, b)
torch.testing.assert_close(c, c_ref, rtol=1e-2, atol=1e-2)

# 性能剖析
kernel = matmul_relu.compile(a, b)
profiler = kernel.get_profiler(tensor_supply_type=tilelang.TensorSupplyType.Normal)
latency = profiler.do_bench()
print(f"Latency: {latency} ms")
pip install tilelang
适合需要最新特性或贡献代码的用户。
git clone https://github.com/tile-ai/tilelang.git
cd tilelang
pip install -e . -v
注意:需预先安装 CMake、LLVM 等依赖。
体验最新功能(可能不稳定):
pip install tilelang -f https://tile-ai.github.io/whl/nightly