Parlor 

7个月前发布 289 00

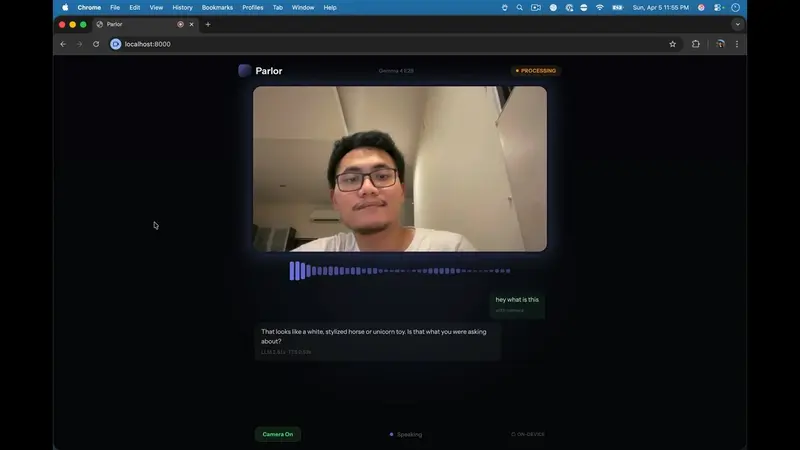
Parlor 是一个开源的研究预览项目,实现设备端(On-Device)、低延迟的多模态 AI 交互。它允许用户通过自然的语音和视觉(摄像头)与运行在本地机器上的 AI 进行对话,无需将任何数据发送到云端。
所在地:
中国
收录时间:
2026-04-09
Parlor Parlor 

Parlor 是一个开源的研究预览项目,实现设备端(On-Device)、低延迟的多模态 AI 交互。它允许用户通过自然的语音和视觉(摄像头)与运行在本地机器上的 AI 进行对话,无需将任何数据发送到云端。

Parlor 

通过结合谷歌最新的轻量级模型 Gemma 4 E2B 和高效的文本转语音引擎 Kokoro,Parlor 在消费级硬件(如 Apple M3 Pro)上实现了流畅的实时互动体验,为隐私敏感型应用和离线场景提供了全新的可能性。

核心亮点

1. 100% 本地运行,隐私至上

  • 零数据外传:所有的语音识别、视觉理解、逻辑推理和语音合成都可以在你的本地设备上完成。
  • 免费且可持续:消除了昂贵的云服务器 API 调用成本,使得大规模部署或个人长期使用成为可能。

2. 真正的多模态交互

  • 视觉理解:AI 可以“看到”你摄像头捕捉的画面,理解物体、场景和动作。
  • 自然语音对话:支持免提交谈,AI 能听懂你的话并看着你的世界做出回应。
  • 多语言支持:基于 Gemma 的多语言能力,用户可以随时切换母语或目标语言(例如用于英语口语练习)。

3. 实时低延迟体验

在 Apple M3 Pro 上,端到端延迟控制在 2.5 – 3.0 秒 左右:

  • 语音+视觉理解:~1.8-2.2 秒
  • 响应生成:~0.3 秒
  • TTS 合成:~0.3-0.7 秒
  • 解码速度:GPU 上约 83 tokens/秒。

4. 先进的语音交互特性

  • 语音活动检测 (VAD):集成 Silero VAD,实现免提、自动侦测说话状态,无需按键通话。
  • 可打断交互 (Barge-in):你可以在 AI 说话时随时插话,AI 会立即停止并倾听新的指令。
  • 流式 TTS:句子级别的音频流式传输,无需等待完整回复生成即可开始播放声音,显著提升感知速度。

技术架构

Parlor 采用简洁高效的 Client-Server 架构:

graph TD
    A[浏览器客户端] -->|WebSocket: 音频 PCM + JPEG 帧| B(FastAPI 服务器)
    B --> C{Gemma 4 E2B via LiteRT-LM}
    C -->|GPU 加速推理| D[理解语音 + 视觉]
    D --> E{Kokoro TTS}
    E -->|Mac: MLX / Linux: ONNX| F[生成语音音频块]
    F -->|WebSocket: 流式音频| A
    A --> G[播放音频 + 显示转录文本]
  • 前端:负责采集麦克风音频和摄像头视频帧,执行本地 VAD,并通过 WebSocket 发送数据。
  • 后端 (FastAPI):
    • Gemma 4 E2B:通过 LiteRT-LM 运行时在 GPU 上高效运行,处理多模态输入。
    • Kokoro TTS:高性能文本转语音引擎,Mac 上使用 MLX 加速,Linux 上使用 ONNX。

快速开始

前置要求

  • Python 3.12+
  • 硬件:配备 Apple Silicon 的 macOS,或带有支持 GPU 的 Linux 系统。
  • 内存:约 3 GB 可用 RAM 用于加载模型。

安装与运行

# 1. 克隆仓库
git clone https://github.com/fikrikarim/parlor.git
cd parlor

# 2. 安装 uv (如果尚未安装)
curl -LsSf https://astral.sh/uv/install.sh | sh

# 3. 进入源码目录并同步依赖
cd src
uv sync

# 4. 启动服务器
uv run server.py

启动后,打开浏览器访问 http://localhost:8000,授予摄像头和麦克风权限,即可开始对话。首次运行时,系统会自动从 Hugging Face 下载 Gemma 4 E2B 模型(约 2.6 GB)和 TTS 模型。

应用场景

  • 语言学习伴侣:随时随地练习口语,AI 可以看图说话,纠正发音,且完全免费。
  • 辅助技术:为视障人士描述周围环境,或通过语音交互获取物体信息。
  • 智能家居中枢:在本地处理语音指令和视觉识别,保护家庭隐私,无需联网即可控制设备。
  • 教育互动:儿童可以通过摄像头展示玩具或绘本,与 AI 进行互动式学习。

⚠️ 注意事项

  • 研究预览:这是一个早期实验项目,可能存在 Bug 或不稳定之处。
  • 硬件限制:虽然 Gemma 4 E2B 非常轻量,但在较旧的 CPU 或不支持 GPU 加速的设备上可能无法达到实时交互的效果。
  • 功能局限:目前的模型适合对话和理解,但不适合复杂的代理式编码或高强度逻辑推理任务。

相关导航

Little Language Lessons

Little Language Lessons

谷歌推出了三项基于其多模态大模型 Gemini 的 AI 实验项目,旨在通过更加个性化、情境化的方式帮助人们提升口语表达能力。些 AI 实验工具为语言学习者提供了全新的视角和方法。无论是通过“微型课程”快速掌握实用短语,还是通过“俚语交流”学习更自然的表达,亦或是利用“单词相机”在实际场景中学习新单词,这些工具都旨在帮助用户更高效地学习新语言。