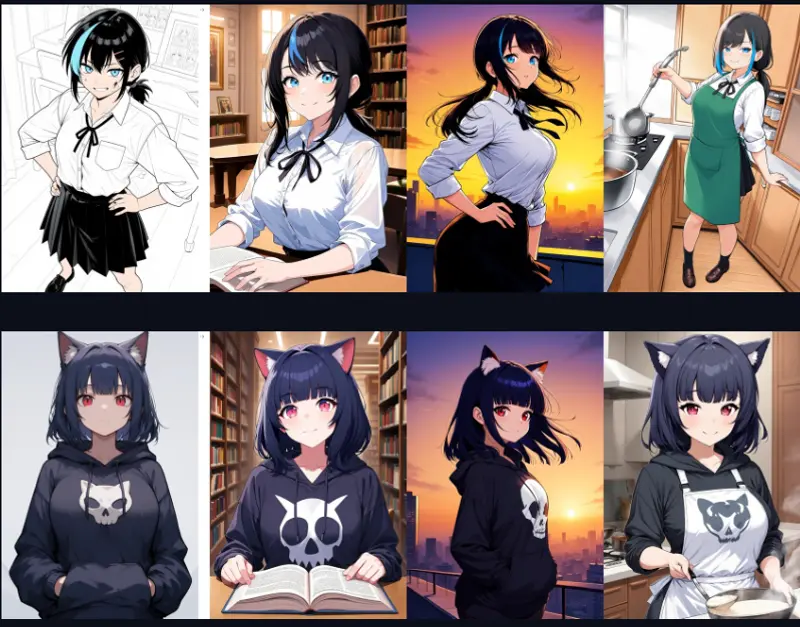
新MOSS-Image CharRef
CharRef v2 是MOSS-Image生态里实用性很强的角色固定方案,依托KV缓存参考编辑路线,省去逐个角色微调LoRA的成本,非常适合漫画、二次元角色跨场景生成;短板集中在写实人脸、精细发型、单参考限制。
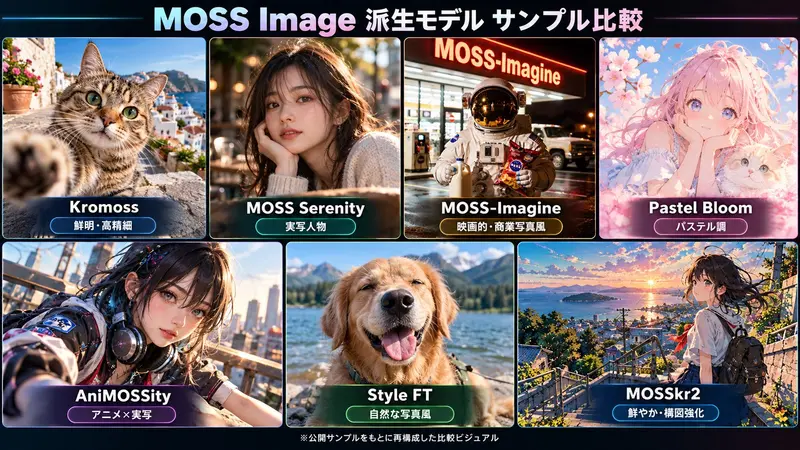
新MOSS-Image微调模型合集
MOSS-Image社区已经形成丰富生态,包含全量Checkpoint微调(画质、人像、电影风)、风格FT、DMD2快速采样LoRA,还有MOSSkr2这种零训练注意力嫁接方案;绝大多数模型兼容原有ComfyUI MOSS工作流,直接替换基座即可。
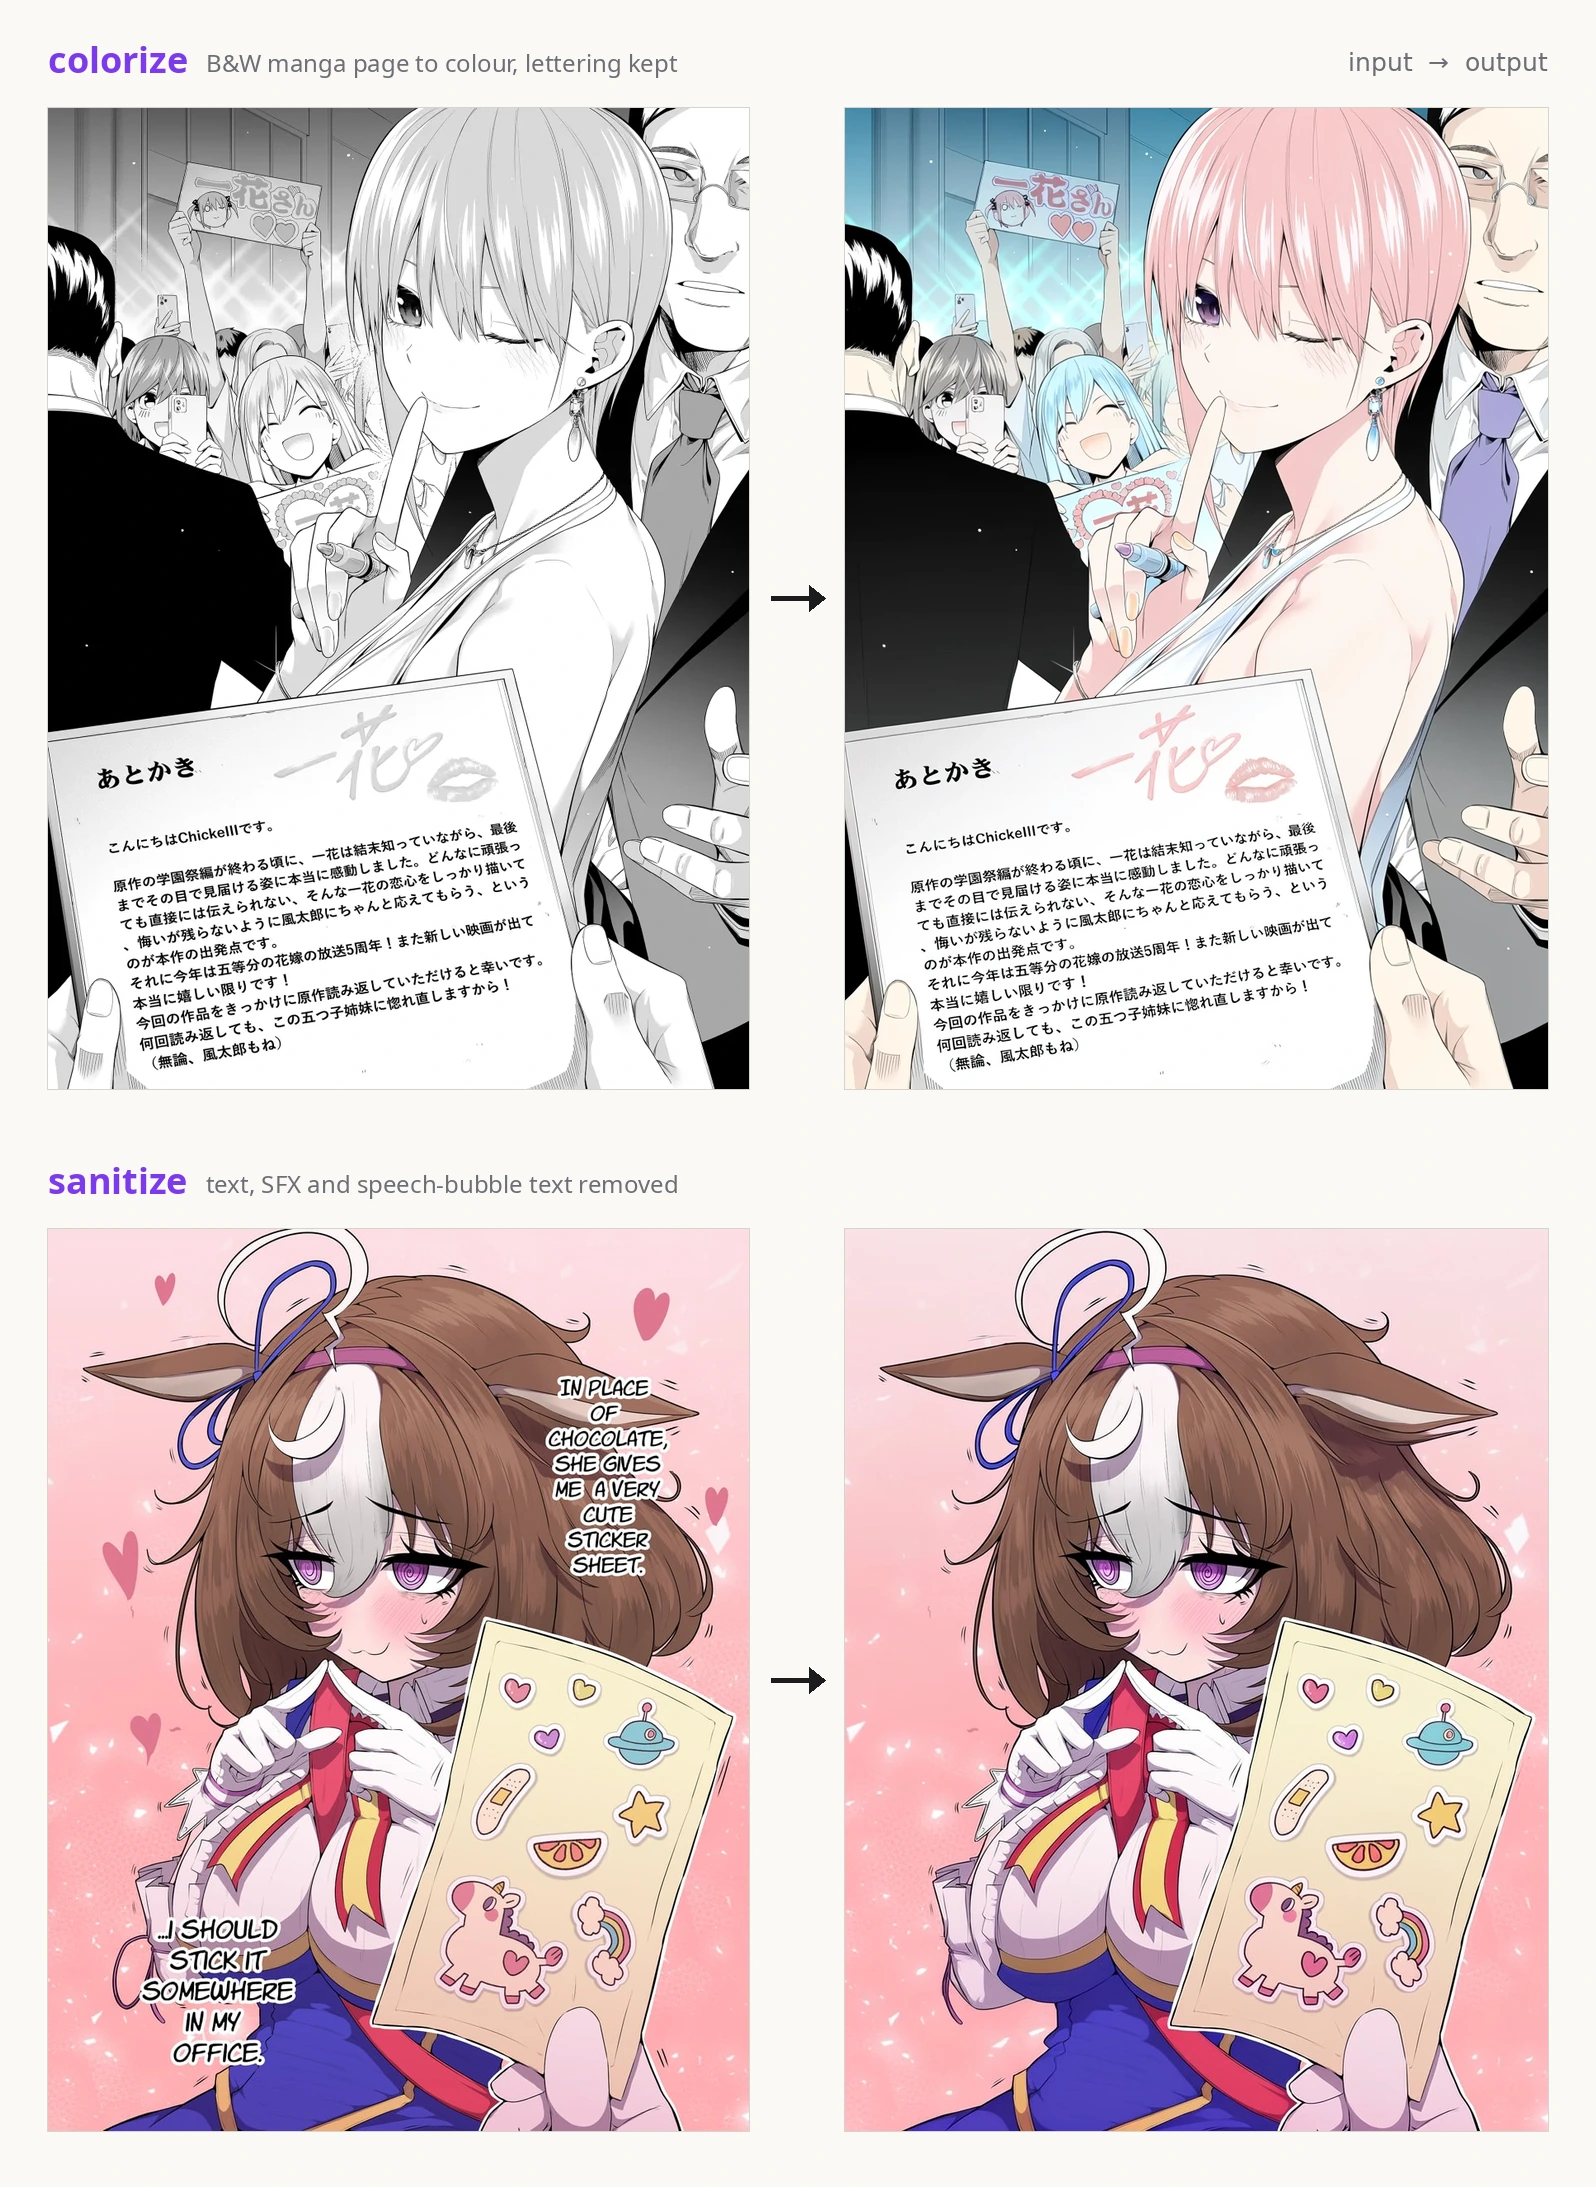
新MOSS-Image i2i LoRAs
这套 MOSS-Image i2i LoRA 为 ComfyUI 打造,包含漫画上色、去文字水印、去马赛克三个独立 LoRA;依托 VAE 潜参考图生图,上色版本数据集充足效果更好,去文字、去遮挡版本训练样本偏少。
Qwen3-VL-32B Ultra Uncensored Heretic — MiniMax-H3 ComfyUI INT8 ConvRot
社区开发者推出了这款基于 Qwen3-VL-32B-Instruct-ultra-uncensored-heretic 定制的文本/视觉条件编码器。 该检查点经过深度裁剪与 INT8 ConvRot 量化,将原本超过 51 GB 的 BF16 模型压缩至约 24.55 GiB,使其能够在 RTX 5090 (32GB VRAM) 等高端消费级显卡上完成加载与推理,是运行 MiniMax-H3 的推荐版本。
10Eros-Max
10Eros-Max 是一个基于 MiniMax H3 基础模型的实验性分支,旨在通过特征迁移(Feature Transfer)技术,将 LTX 2.3、Wan 2.2 以及 Krea 2 的学习模式融合到 H3 的 Transformer 架构中。该模型在保留 H3 核心音视频生成能力的同时,显著增强了视觉细节、运动连贯性及文本遵循能力。
MOSS-Image-SFT-4-steps
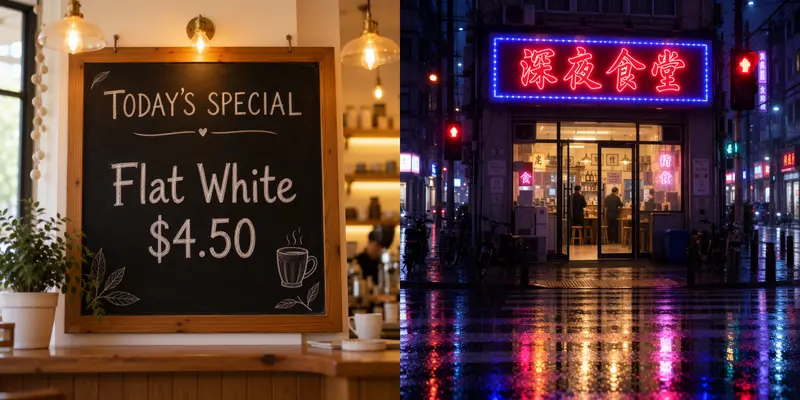
MOSS-Image-SFT-4-steps v2.0 完成重大改版,精简为单个 LoRA 文件,原生适配标准 Euler 采样器,无需额外自定义组件。它支持 4 步快速出图,中英文字、数字保真度在同类型少步模型中表现突出,最高支持 2048×2048 无平铺生成。
新MiniMax-H3-PTD-RefAsymOPD-LoRAs
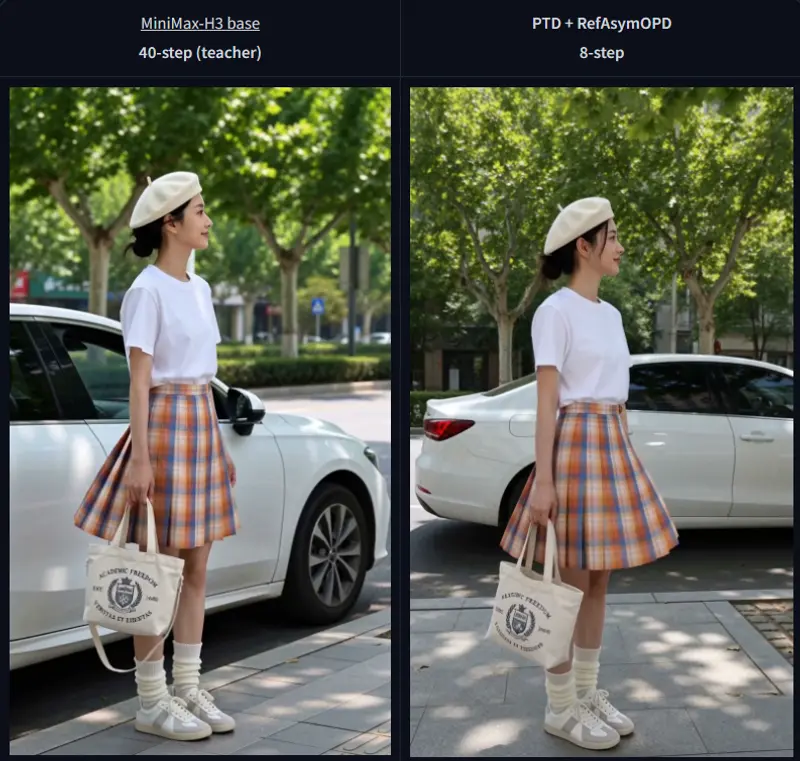
MiniMax-H3 Ref2VA PTD + RefAsymOPD 加速 LoRA 代表了当前参考图像到音视频生成领域的一项高效工程实践。它通过精巧的同策略蒸馏设计,成功打破了“推理速度”与“生成质量”之间的传统权衡,为需要在本地或云端进行高频、高质量 Ref2VA 生成的开发者和创作者,提供了一套低成本、高保真且易于集成的解决方案。
新MOSS-Image-Edit-HQ
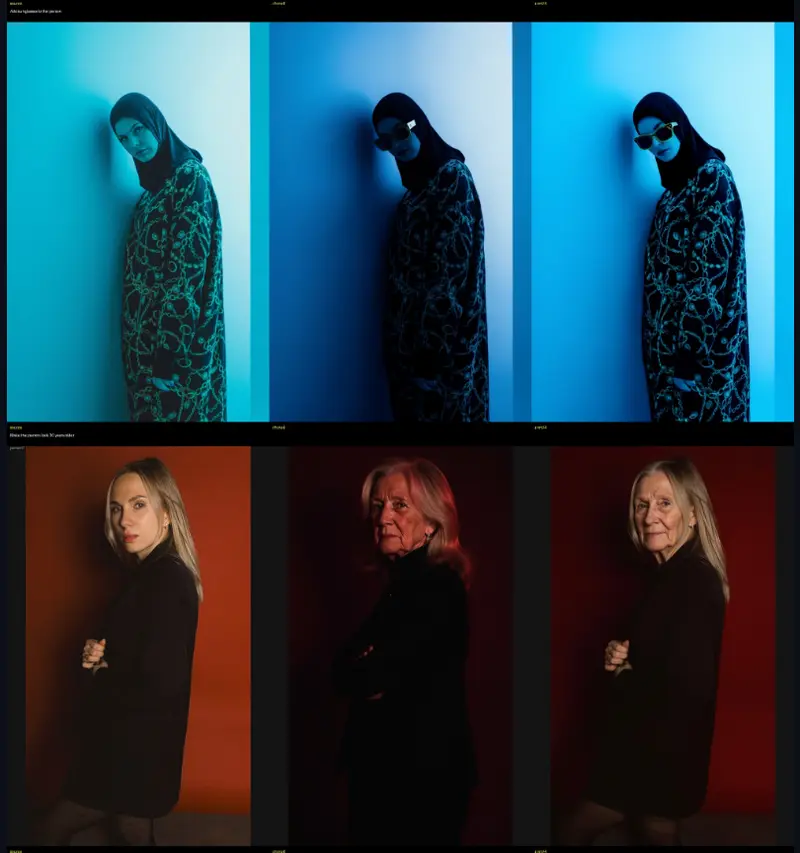
MOSS-Image-Edit-HQ armV4 是 MOSS-Image-SFT 社区图像编辑 LoRA,依靠掩码损失解决旧版全局色彩漂移问题,面部编辑明显变强;同时提供原生 ComfyUI 和插件两种接入格式,适合做局部改写、光影重绘,但显存开销较高,不兼容 Base 系列模型。
MiniMax-H3-Facial-Realism-CloseUp
MiniMax-H3-Facial-Realism-CloseUp 是一款专为 MiniMax H3 模型设计的实验性 LoRA 适配器,显著提升人像特写视频中的面部真实感与微表情细节。
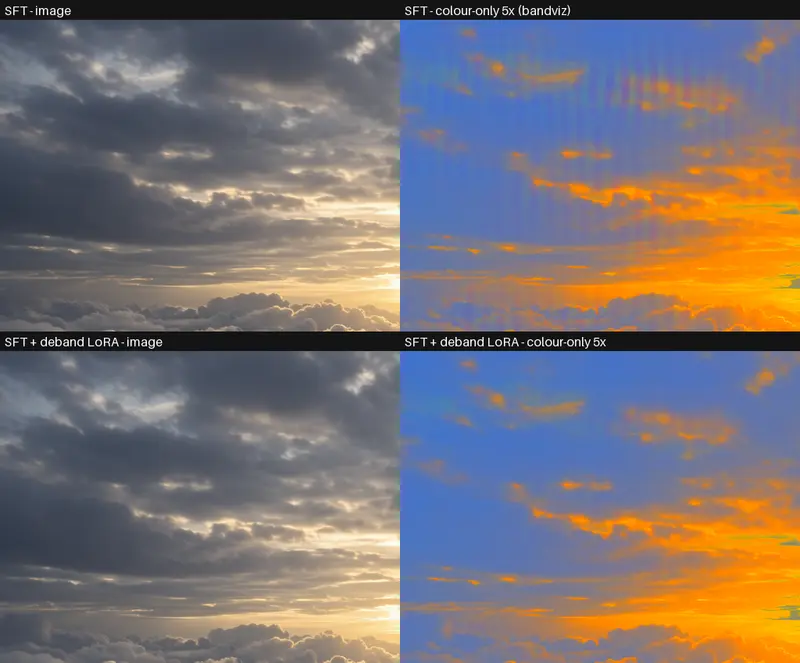
sft-destripe
1.9MB的SFT Destripe LoRA依靠权重方向提取而非训练制作,专门消除MOSS-Image SFT在平滑背景产生的垂直色带,几乎保留原有图像风格,在ComfyUI只需简单加载即可使用。





