OpenAI 今天正式推出了 GPT-6.1 Terra,这是一款专为平衡速度、能力与成本而设计的高效模型。该模型在细致的视觉推理、精准的计算机操作(Computer Use)以及自然流畅的文本生成方面实现了显著升级,旨在为开发者和企业提供极具性价比的大批量任务自动化解决方案。
核心定位:重塑成本与智能的平衡
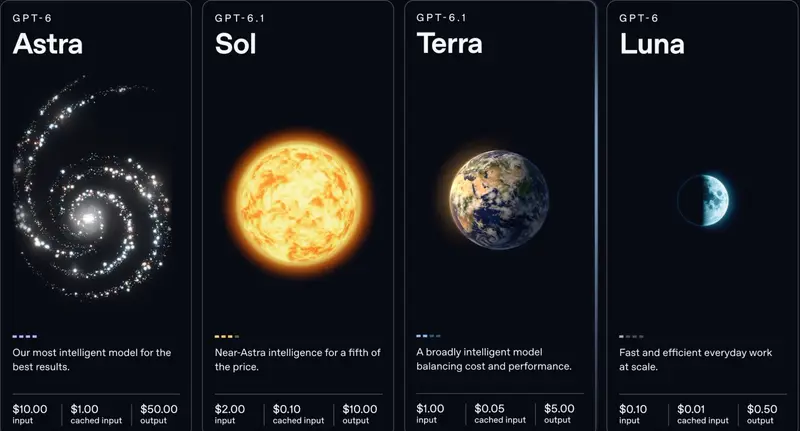
GPT-6.1 Terra 延续了 Terra 系列的高效基因,但在多项关键指标上实现了代际跨越。其标准 API 定价较前代 GPT-5.6 Terra 和同级的 GPT-6.1 Sol 降低了 50%。这意味着在相同的订阅额度或 API 预算下,用户能够完成更多日常沟通、文档处理(如读取发票并录入会计软件)、表单填写及视频剪辑等自动化任务,极大提升了模型的投入产出比。
卓越的基准测试表现
在多项权威及内部基准测试中,GPT-6.1 Terra 展现了越级的性能表现:
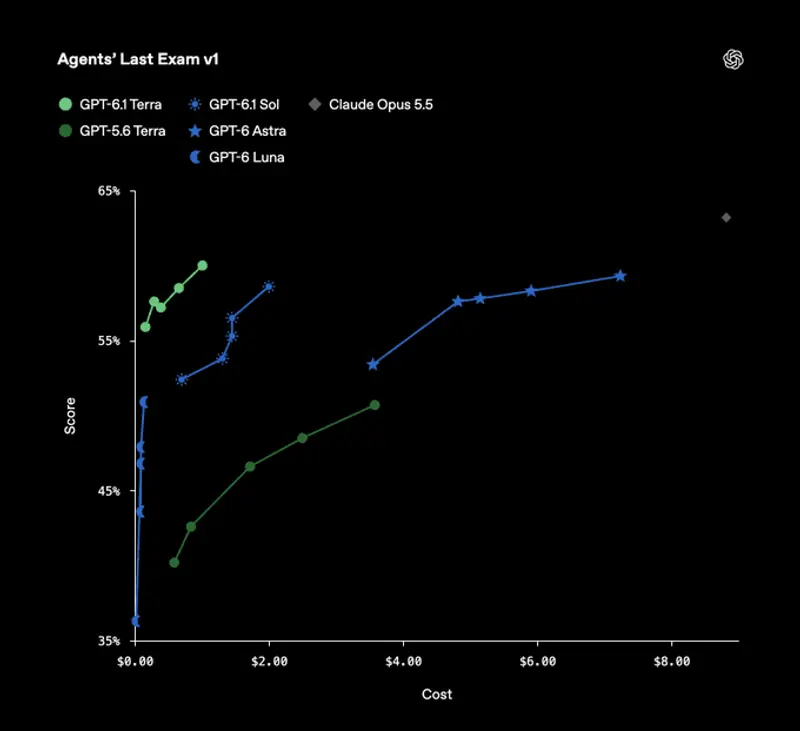
- 计算机操作能力 (Agents’ Last Exam):在中等推理强度下,其得分比 GPT-5.6 Terra 高出 15 个百分点,而成本仅为后者的三分之一。其表现已媲美旗舰模型 GPT-6 Astra,但每个 Token 的价格仅为 Astra 的十分之一,任务完成速度更是 Astra 和 GPT-6.1 Sol 的三倍以上。
- 视觉推理 (MMMU-Pro):在所有推理设置下均优于 GPT-5.6 Terra,并以显著更低的成本,取得了接近 GPT-6 Astra 和 GPT-6.1 Sol 的分数。
- 桌面应用多步任务 (OSWorld 2.1):在中等推理强度下即可超越 GPT-5.6 Terra 的最佳成绩,且每项任务成本大幅缩减。
- 事实准确性:经过针对性的反幻觉优化,在易诱发错误的内部基准测试中,低推理强度下的错误率从 53.6% 骤降至 16.7%;在最高推理强度下,错误率进一步降至 4.3%,逼近旗舰模型水平。
- 软件工程与科研 (Terminal-Bench):在 Terminal-Bench 4.0(命令行问题解决)中,最高推理强度下的任务解决率达到 50.3%,是 GPT-5.6 Terra 的两倍以上。在 Terminal-Bench-Science 0.1(代码执行科研任务)中,以不到 GPT-6.1 Sol 五分之一的成本实现了超越,并与 Claude Opus 5.5 的差距缩小至五分以内。
强化的安全与对齐机制
在提升效率的同时,OpenAI 并未妥协安全性。GPT-6.1 Terra 已达到其准备框架中网络安全领域的“严重”风险阈值,并完整继承了为 GPT-6 Astra 开发的先进防护措施。评估显示,该模型在遵循任务边界、如实说明自身局限性以及抵御恶意的提示词注入(Prompt Injection)攻击方面,均比 GPT-5.6 Terra 表现出更强的鲁棒性。
定价与可用性指南
GPT-6.1 Terra 现已全面开放,开发者可通过以下途径接入:
- 消费级与企业级应用:所有 ChatGPT Plus、Pro、Enterprise 和 Edu 用户,以及 Codex 用户,现已可直接在界面中调用该模型。
- 开发者 API:通过 OpenAI API 以
gpt-6.1-terra模型标识符进行调用。 - 极具竞争力的定价:
- 输入 Token:$1.00 / 百万 Token
- 缓存输入 Token:$0.05 / 百万 Token
- 输出 Token:$5.00 / 百万 Token
© 版权声明
文章版权归作者所有,未经允许请勿转载。