Olm SoL Refiner 是面向ComfyUI开发的实验性自定义节点,封装NVIDIA SoL Refiner的MiniMax-H3权重,核心能力是使用已经解码出来的视频帧+文本提示词,完成视频的生成式精炼与分辨率放大。
- GitHub:https://github.com/o-l-l-i/ComfyUI-Olm-SoL-Refiner
- 模型:https://huggingface.co/Efficient-Large-Model/SoL-Refiner-LTX-2.5-for-MiniMax-H3
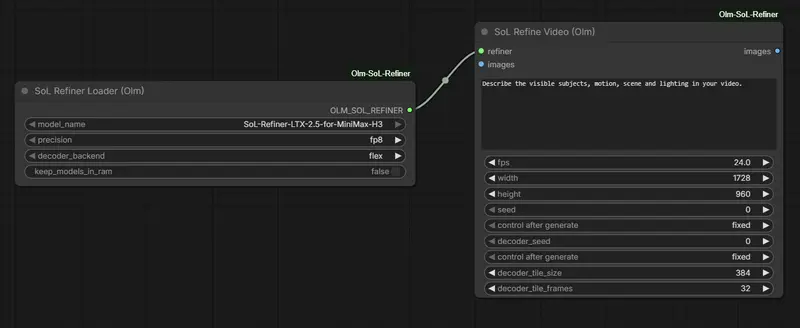
它最大特点:输入素材不要求来自LTX、也不依赖MiniMax模型或潜变量,普通视频帧即可送入精炼。
⚠️ 实验性质:属于生成式重绘精炼,画面细节会发生改变,人脸、服饰纹样、珠宝细节都可能变动。如果要求画面高度相似、严格保留原图细节,一定要做好对照测试。
安装步骤
- 进入ComfyUI
custom_nodes目录,拉取仓库
git clone [https://github.com/o-l-l-i/ComfyUI-Olm-SoL-Refiner.git](https://github.com/o-l-l-i/ComfyUI-Olm-SoL-Refiner.git)
- 在ComfyUI内置Python环境安装依赖
python -m pip install -r ComfyUI-Olm-SoL-Refiner/requirements.txt
- 重启ComfyUI。
测试环境:ComfyUI 0.31.0、Python3.13、PyTorch2.13 + CUDA13;RTX5090(32GB显存+128GB内存)。小显存显卡、其他系统暂未验证。需要固定版本Diffusers;Windows环境需要Triton3.7,Triton版本需要和PyTorch匹配。
- 下载模型仓库,总大小约71GB,保持目录结构完整:
路径示例:ComfyUI/models/sol_refiner/SoL-Refiner-LTX-2.5-for-MiniMax-H3/
内含model_index.json,connectors、diffusion_decoder、vae等子文件夹。
可在extra_model_paths.yaml配置外部模型目录:
external_models:
  sol_refiner: E:/Models
配置后模型放在E:/Models/SoL-Refiner-LTX-2.5-for-MiniMax-H3/即可。节点会扫描文件夹名称包含sol、带model_index.json的目录;不要修改原始模型文件夹名,修改路径后重启ComfyUI。
节点只会读取本地文件,不会自动下载模型、修改权重。
基础工作流
加载示例工作流即可快速上手,把占位提示词替换成描述画面内容、动作的文本。
- Load Video → Get Video Components:提取视频帧、音频、帧率
- SoL Refiner Loader (Olm):选择模型与精度
- SoL Refine Video (Olm):设定输出分辨率做精炼放大
- Create Video → Save Video:合并原始音频、原帧率导出视频
举例:输入864×480,输出尺寸设置1728×960,实现2倍放大。
节点输出标准IMAGE批次,也可搭配其他第三方视频读写节点。帧数、FPS原样保留,音频直接透传,不会经过模型处理。
参数说明
| 参数 | 说明 |
|---|---|
| precision | 默认推荐fp8;bf16占用更多内存;nvfp4为Blackwell架构实验选项,针对大transformer层量化 |
| decoder_backend | Windows测试环境推荐flex;首次加载/新分辨率会触发编译;natten需要额外安装,本节点未测试 |
| keep_models_in_ram | 默认关闭;开启后反复跑图加载更快,但会占用数十GB内存 |
| Decoder tiles | tile越小显存占用越低,但容易出现接缝、纹理破损 |
| Seeds | 精炼、解码阶段拥有两套独立噪声种子 |
内存相关说明:节点复用ComfyUI内存管理,任务结束/取消任务后自动卸载模型;即便transformer使用FP8量化,文本编码器体积依旧很大。不支持–novram启动参数。建议先用短片段测试,编译和解码耗时通常会超过精炼本身。
示例对比
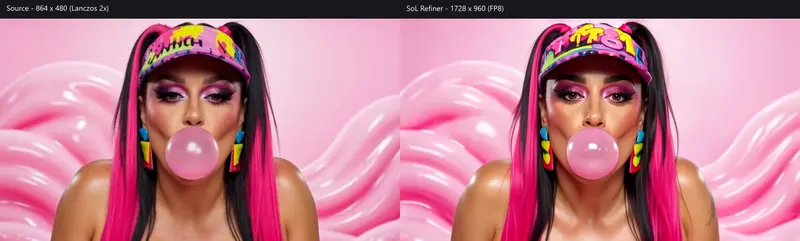
测试素材:158帧、24fps视频,取中间第79帧。左侧原图864×480用Lanczos插值放大;右侧为模型输出1728×960。
测试配置:FP8、Flex attention、种子0/0,解码器tile 384px / 32帧。
备注:静态帧无法体现视频时序一致性;这是本地测试样例,不能作为模型全局性能基准。提示词里的图像参考描述,并不会额外读取参考图输入。
核心要点
- 节点定位:ComfyUI自定义节点,NVIDIA SoL Refiner实验视频精炼器;输入是RGB视频帧,不需要潜变量,素材来源不限。
- 能力:文本提示词引导生成式细节增强+视频超分;会改动画面细节,不适合要求严格保真的场景。
- 硬件门槛:测试在RTX5090 32G,模型包71GB;依赖特定版本Diffusers、Triton。
- 工作流:音频直接透传,FPS/帧数不变;FP8是推荐精度,tile大小用来平衡显存与画面质量。
© 版权声明
文章版权归作者所有,未经允许请勿转载。