HardenedLinux 推出 Velum,是 CosyVoice3 文本转语音模型的原生C++重实现,采用现代C++开发,编译输出单个可执行文件,运行阶段完全不依赖Python,非常适合批量Agent产品部署。
- GitHub:https://github.com/hardenedlinux/velum
原版CosyVoice推理基于Python生态,依赖包体积庞大、版本冲突问题频发,在大量Agent能力集成场景下部署成本很高。Velum把神经网络推理(LLM / Flow / HiFT)跑在GGML上,支持CUDA硬件加速;模型权重转换、声学前端预处理(campplus、speech tokenizer、matcha mel)仅需要离线一次性用Python完成,推理运行时不再需要Python环境。
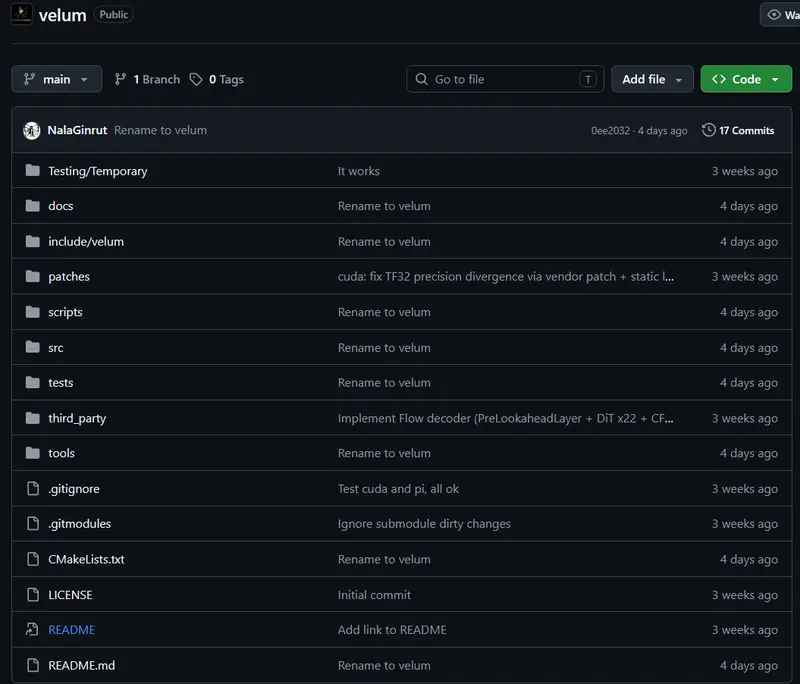
该项目架构由人类规划,核心代码由DeepSeek-v4-pro编写,Claude Code辅助编码,也是Vibe Coding落地的典型工程案例。
项目模块与目录结构
整套管线分为DSP、LLM、Flow、HiFT声码器四大核心模块,全部完成数值校验,对照PyTorch原版做验证:
| 目录 | 功能 |
|---|---|
| src/dsp/ | Whisper log-mel、Kaldi fbank信号处理,已验证 |
| src/llm/ | Qwen2解码器 + CosyVoice3LM头部 + ras采样,已验证 |
| src/flow/ | DiT Flow-Matching估计器,CFM欧拉求解,已验证 |
| src/hift/ | 因果HiFi-GAN声码器,已验证 |
| src/pipeline/ | 整体编排:文本tokenizer → LLM → Flow → HiFT |
| src/cli/ | velum端到端命令行入口 |
| src/frontend/ | 预留ONNX前端(当前离线预处理) |
| tools/ | 离线资产脚本:权重转换、tokenizer导出、GGUF转换 |
| tests/ | 数值校验脚本,用来和PyTorch基准比对 |
| docs/ | 架构文档、算子设计、误差说明 |
暂未在C++内部实现campplus、speech tokenizer与matcha mel;这部分仍在Python离线一次性运算,输出文件供C++程序读取,社区版不会补齐该部分,企业可咨询付费定制。
构建与硬件
通过CMake编译,自动检测CUDA工具链,同时内置CPU、CUDA两套后端,运行时自动优先使用GPU,无GPU则回退CPU。
cmake -S . -B build
cmake --build build -j
- LLM的GGUF文件约2.6GB,CUDA推理需要预留足够显存,LLM+Flow图合计约占用4GB显存,8GB显卡会出现显存不足;可设置环境变量
VELUM_BACKEND=cpu强制CPU运行。 - 动态链接依赖系统基础库、CUDA相关库,编译后得到独立
velum主程序与验证调试工具。
离线资产准备(一次性,仅预处理阶段需要Python)
需要两套Python环境,分别用于权重转换与CosyVoice前端资产导出:
- 转换模型权重,将PyTorch模型转为GGUF格式;
- 导出tokenizer词表;
- 导出HiFT、Flow模块固定RNG缓冲区;
- 提取提示语音的speaker特征、prompt token与mel特征。
推理运行命令
./build/velum \
  --text "今天天气不错,我们一起去公园散步吧。" \
  --prompt-dir wavs/flow_inputs \
  --out wavs/hello.wav
支持指定seed控制LLM采样,还可以导出token、mel频谱、原始PCM音频用于调试。
数值验证标准
使用归一化相对误差做判定,和原版PyTorch输出比对:
- GREEN:误差≤1%,浮点精度内与参考对齐,脚本强制通过标准
- YELLOW:1%~10%,超出理想阈值但不算结构性错误
- RED:>10%,算子/布局存在缺陷,直接判定失败
端到端测试结果:CPU、CUDA后端均达到GREEN等级。长文本场景下仅音频起始少数样本出现小幅误差,绝大部分样本误差可控,不属于逻辑缺陷。
重要设计选择:CFM Flow噪声缓冲区固定为种子0,一次性导出冻结二进制文件,不可在推理时修改随机种子,以此保证每次推理可复现。
核心要点
- 运行时零Python,编译得到单可执行文件,部署仅需要拷贝二进制,大幅解决Python依赖臃肿、版本冲突问题,适合大规模Agent产品;
- 四大核心模块全部完成数值验证,CPU/CUDA双后端,GGML作为推理底层;
- 声学前端保留离线Python预处理,社区版不补齐,企业可付费咨询;
- Flow解码器噪声固定种子0,追求推理确定性、结果可复现;
- 工程案例:人类做架构设计,DeepSeek-v4-pro主力编码,Claude Code辅助,证明复杂底层C++项目可由AI完成Vibe Coding。
© 版权声明
文章版权归作者所有,未经允许请勿转载。