科大讯飞今日正式推出新一代语音识别大模型 Spark-ASR-2.0,依托多项技术创新,在复杂环境、混合语言识别与文本润色能力上实现显著提升,推理成本仅较上一代Spark-ASR-1.0增加10%。
该模型采用非自回归与LLM增强自回归协同架构,搭配中英文混合文本与声学联合增强、动态上下文注入等核心技术。
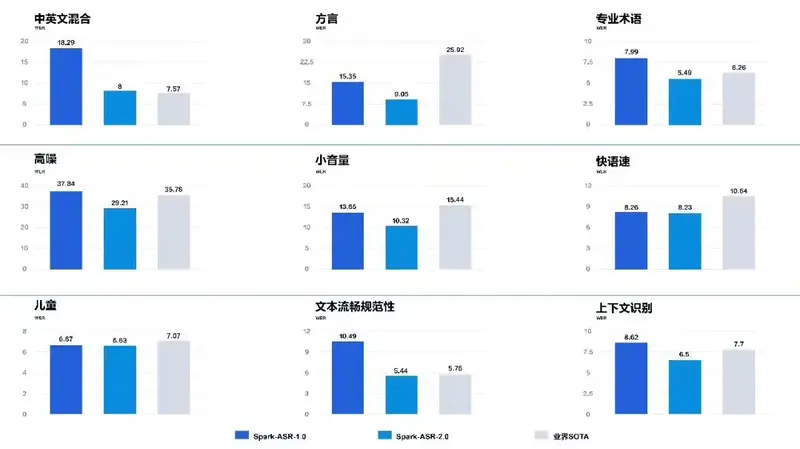
测试集中 ASR 任务使用 WER / CER 作为评价指标,数值越低表示效果越好 * 测试集来自于语音真实任务请求数据,来源分布包括讯飞星火 APP、讯飞听见 APP、讯飞翻译机、讯飞输入法、讯飞开放平台语音 API 真实开发者场景等进行滚动更新。
过去语音识别的目标大多是一字不差还原语音内容,而Spark-ASR-2.0提出新目标:识别结果流畅成文。在提升识别准确率的基础上,结合上下文语义理解,自动精简口语冗余、修正表达细节,输出连贯通顺的文字。
在核心能力上,模型针对几大难点场景重点优化:中英文混杂语句、多方言识别、专业术语、高噪音环境、低音量、快语速、儿童语音识别,同时强化上下文记忆,降低词错误率WER。官方数据表示,对比当前行业顶尖方案,该模型在方言、高噪、小音量场景优势突出,多项任务指标优于业界最优水平。
落地规划方面:Spark-ASR-2.0明日起逐步上线讯飞输入法,同时在讯飞开放平台开放API调用;后续还会陆续部署至讯飞AI眼镜、智能办公本、讯飞听见等硬件与服务产品线。
© 版权声明
文章版权归作者所有,未经允许请勿转载。