Vulsar AI 近日发布一项针对创意写作能力的基准测试,通过 475 个提示词对 24 个大语言模型与人类作家进行对比评估。结果显示,仅有 GPT-6 Astra 等极少数前沿模型在整体读者偏好预测中略微超过业余人类作家,而所有模型均显著落后于专业作家。这一发现与“AI 即将全面取代写作职业”的流行论调形成鲜明反差,揭示了当前 LLM 在复杂叙事任务中的真实能力边界。
- 榜单地址:https://vulsar.ai/benchmarks/creative-writing-v1
该基准采用在人类偏好数据上微调的奖励模型作为评判器,预测读者对生成内容的整体偏好。测试覆盖长文本生成场景,重点考察连贯性、风格控制与结构完整性,而非短片段或事实准确性。这种设计更贴近真实创作需求,避免了传统 NLP 指标(如 BLEU、ROUGE)与人类感知脱节的问题。
排行榜分层明显:万亿参数是分水岭
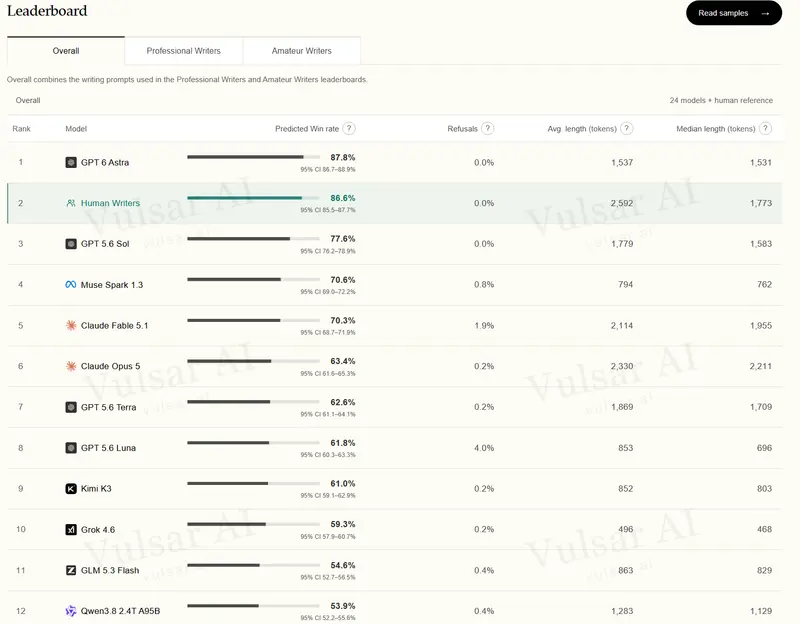
根据公布的胜率数据,模型表现呈现清晰的梯队分化:
- 第一梯队(>85%):GPT-6 Astra(87.8%)略高于业余人类作家(86.6%),是唯一稳定超越人类基线的模型。
- 第二梯队(70–80%):GPT-5.6 Sol(77.6%)、Claude Fable 5.1(70.3%)接近但未达人类水平。
- 第三梯队(50–65%):Claude Opus 5、Kimi K3、Grok 4.6 等高知名度模型落入此区间,表现与人类基线持平或略低。
- 第四梯队(<30%):Qwen3.8-27B(23.2%)、DeepSeek V4.1 Flash(19.8%)、Gemma 4 26B(10.9%)等中小模型大幅落后。
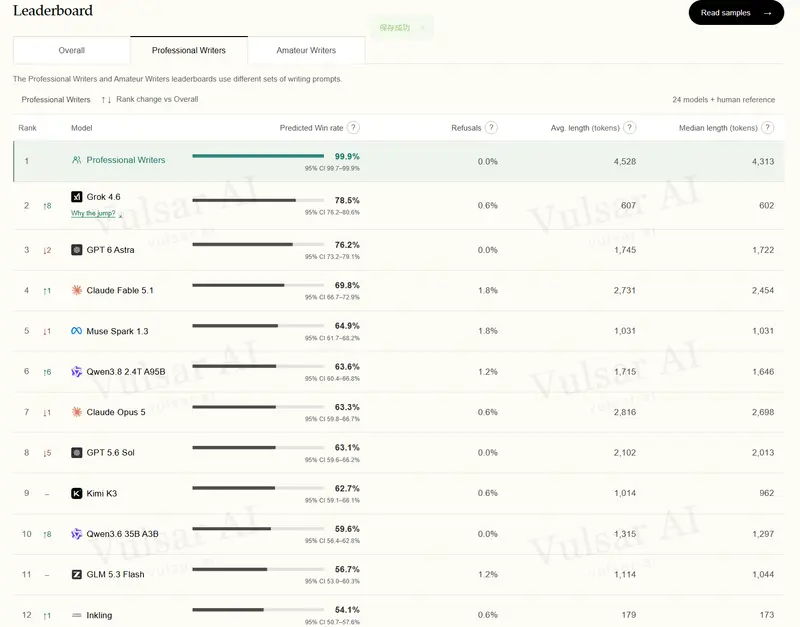
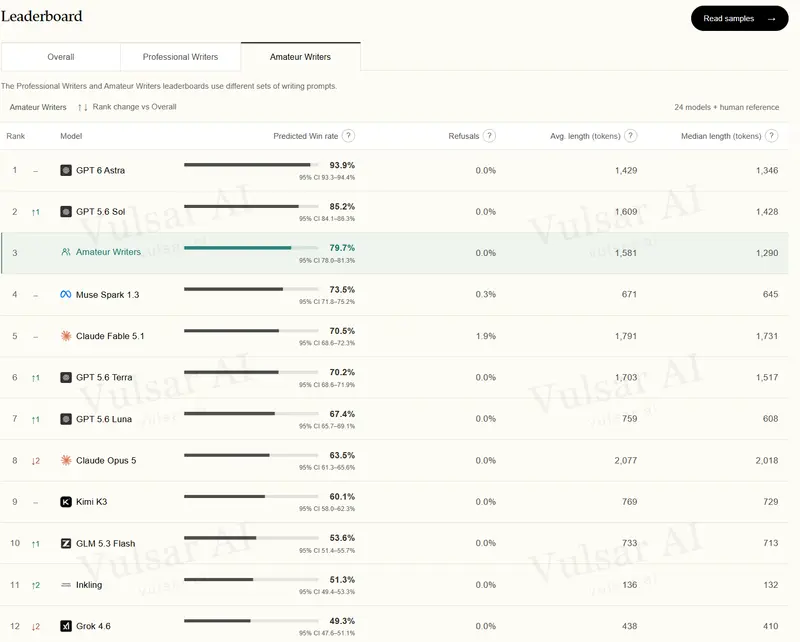
值得注意的是,业余人类作家与专业作家之间存在巨大技能鸿沟。尽管 GPT-6 Astra 超越了前者,但在单独评估中,专业作家的得分仍显著更高。这表明当前 AI 尚未触及专业创作的核心能力层。
输出长度与连贯性:小模型的致命短板
在 token 生成量方面,人类作家平均每提示词产出 2,592 tokens,远超 GPT-6 Astra(1,537)和 Claude Fable 5.1(2,114)。Reddit 社区反馈指出,中小模型在多章节长文任务中普遍存在两大问题:
- 叙事连贯性丧失:跨段落逻辑断裂,角色行为前后矛盾。
- 重复短语泛滥:为填充长度反复使用相同句式或描述,暴露生成机制的机械性。
相比之下,人类作家凭借自发思维与全局构思能力,可动态调整节奏、风格与信息密度,维持复杂叙事的内在一致性。这种“活”的创作弹性,仍是当前自回归语言模型难以复制的特质。
规模并非万能,架构与训练目标同样关键
测试结果暗示,单纯增加参数量并不自动转化为创意写作优势。GPT-6 Astra 的领先可能源于以下因素的组合:
- 超长上下文训练:支持数万 token 的有效注意力,减少长文遗忘。
- 偏好对齐深度:奖励模型不仅优化流畅度,还内化了叙事张力、情感节奏等隐性标准。
- 多阶段生成策略:可能引入大纲规划、分段校验等工程手段,弥补纯端到端生成的结构性缺陷。
而中小模型即便参数效率提升,在缺乏针对性长文训练与人类级偏好信号的情况下,仍难突破连贯性瓶颈。这提示行业需重新审视“小而美”路线在创意任务中的适用边界。
使用建议与认知校准
对于内容创作者与技术选型者,本基准提供三点务实参考:
- 区分任务层级:若需求为摘要、改写、短文案,多数主流模型已足够;若涉及长篇原创、人物弧光、世界观构建,目前仅 GPT-6 Astra 可作为辅助起点,且仍需大量人工修订。
- 警惕“胜率”误导:87.8% 的预测胜率不等于“比人写得好”,而是“在特定奖励模型下更接近人类偏好分布”。实际应用中应结合自身审美标准二次验证。
- 关注专业作家反馈:基准未纳入专业作家直接评分,其真实差距可能被低估。建议在高要求场景中优先采集领域专家意见,而非依赖自动化指标。
Vulsar AI 的这项测试并未否定 AI 写作的价值,而是将其置于更真实的坐标系中。它提醒我们:技术的进步值得肯定,但对人类创造力的敬畏不应被轻易消解。真正的协作,始于认清彼此不可替代的部分。
© 版权声明
文章版权归作者所有,未经允许请勿转载。