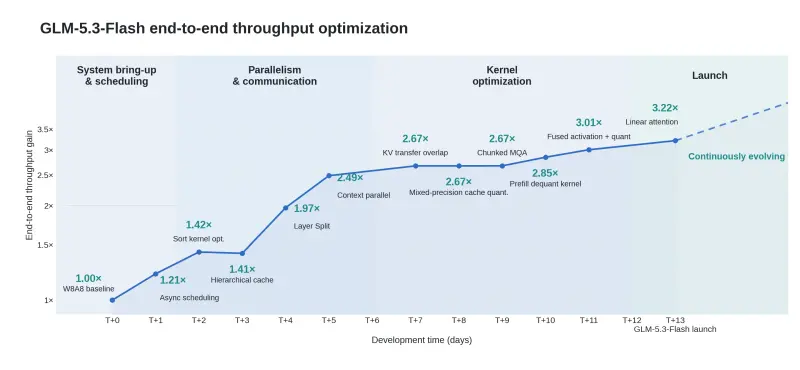
智谱披露,GLM-5.3-Flash 的生产推理已经部署在超过10万块国产AI加速器上。从模型首次跑通到正式投产仅用时不到两周,端到端吞吐量提升3.2倍。整套推理优化工作的主力并非工程师团队,而是由GLM-5.3驱动的AI智能体,实现模型优化承载自身运行的推理系统。智谱CEO唐杰表示,这是最小的自我改进闭环,但距离完整递归自我提升还有很远。
严苛部署环境与优化取舍
国产加速器存在显存、带宽受限,软件生态不完善、文档缺失等难点;同时GLM-5.3-Flash需要支持百万Token长上下文与多模态请求。智能体完成多维度工程权衡:
- ReplaySSM:用计算换取显存
- 节点内张量并行:用通信换取显存
- INT8/FP8/BF16混合缓存:精度换显存容量
- 编码-预填充-解码架构分离,提升调度灵活性
最终实现国产芯片上单Token成本对标主流英伟达GPU。
核心思路:把工程师隐性经验转为「密集反馈」
智能体写代码能力本身不是瓶颈,难点在于性能异常定位。吞吐量下降这类全局指标属于稀疏奖励,一次完整基准测试耗时数小时,试错成本极高,很难判断根因。
智谱的解决方案是搭建分层验证接口,提供低成本、可局部验证的三类密集反馈信号:
- 正确性反馈:验证计算结果是否准确
- 系统行为反馈:定位时间消耗在哪个环节
- 性能反馈:对比不同方案在对应条件下优劣
依靠这套机制,AI智能体自主发现并修复了三个真实底层工程问题:
- 精度漂移问题:KDA内核上下文并行路径,TF32舍入误差在链式状态矩阵合并持续累积,上下文越长漂移越严重。该修复已合并至开源项目 Flash Linear Attention。
- 并发瓶颈:KV缓存传输与计算本应并行,但实际无法重叠。智能体追踪到Python/C++边界,DeepEP节点内路径没有释放GIL全局解释器锁,传输线程无法调度。修复后该项开销从30%+降至1%以内。
- 重复计算冗余:解码内核分块逻辑导致归一化运算重复执行4次。智能体参考SGLang、FLA、DeepGEMM等开源内核提炼优化思路,重组计算结构,获得1.71倍加速。
人机分工与长期启示
- 人的职责:目标设定、搭建反馈环境、高风险变更审查。工程师角色从直接解决性能问题,转变为设计反馈体系。
- 长期价值:这套面向真实基础设施任务的分层可验证反馈环境,产出的任务样本,可作为下一代模型的训练素材。
官方文章地址:《Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure》
© 版权声明
文章版权归作者所有,未经允许请勿转载。