阶跃星辰正式推出 StepAudio3 系列音频大模型,一共包含五款模型:StepAudio3Realtime、StepAudio3ASR、StepAudio3TTS、StepAudio3Gen、StepAudio3Music。多款模型在 Artificial Analysis 权威评测榜单拿下全球第一,整套模型现已上线阶跃星辰开放平台。
- 项目主页:https://stepaudiollm.github.io/step-audio-3-gen
整套StepAudio3系列覆盖五大音频核心场景:真人级语音合成、完整音频内容生成、实时语音对话交互、复杂场景语音理解、音乐创作,覆盖语音交互到音频内容生产全链路。
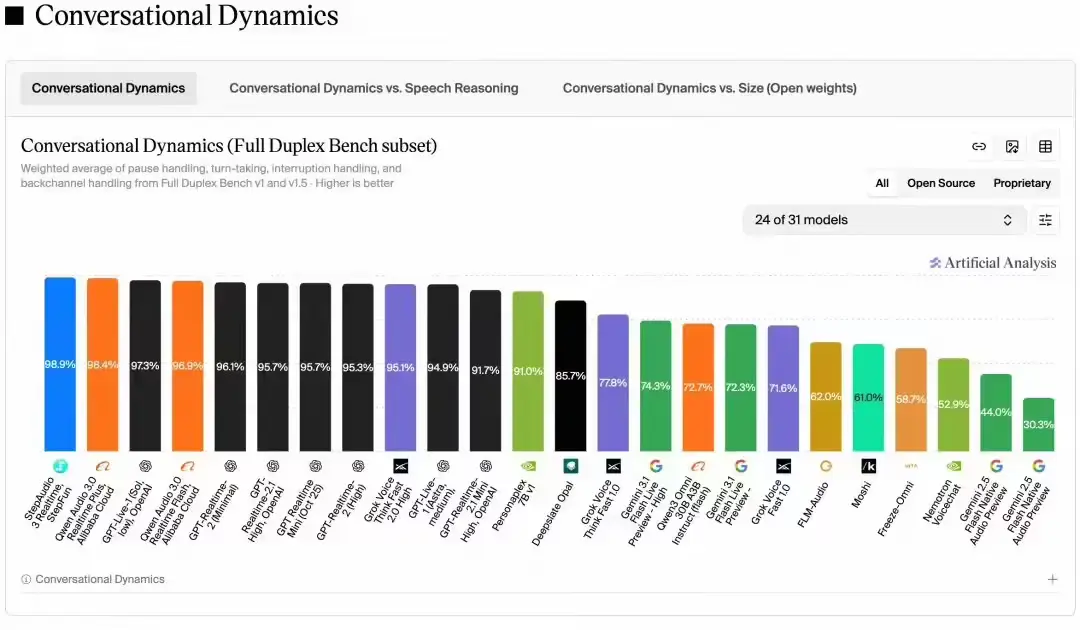
核心亮点:多项指标全球登顶
| 模型 | 核心能力 | Artificial Analysis 排名/成绩 |
|---|---|---|
| StepAudio 3 Realtime | 实时语音交互、推理与行动 | Conversational Dynamics: 98.9% (全球第1) Speech Reasoning: 99.7% (全球第1) |
| StepAudio 3 ASR | 复杂场景语音理解与识别 | 非流式语音识别 WER: 1.7% (并列全球第1) |
| StepAudio 3 TTS | 真人级情感语音合成 | 业界领先的自然度与副语言表现力 |
| StepAudio 3 Gen | 人声、音效、环境、音乐统一生成 | 支持多角色、多轨道精细控制 |
| StepAudio 3 Music | 结构化音乐创作与编曲 | 支持 ABC 记谱法、清唱配乐及多轮交互 |
StepAudio3 Realtime:懂对话节奏的原生实时语音模型
当前不少实时语音模型已经实现全双工、打断能力,但更高阶的体验,在于模型能听懂对话节奏,边听边思考、自主判断什么时候应答。
StepAudio3 Realtime 原生支持全双工实时对话,在 Artificial Analysis 两项榜单取得全球第一:对话动态综合得分98.9%;语音推理准确率99.7%。
它不只是转写文字再回答,可同时解析语义、语气、情绪、副语言以及环境背景音,依托完整音频信息理解用户意图。模型支持推理和语音生成并行;工具调用、长任务可以异步执行,不会阻断当前对话。任务后台运行期间,用户依旧可以随时继续交流,任务完成后自然接续上下文,实现听、说、思考、执行一体化。
StepAudio3 ASR:不止听清,更能理解语境
传统语音识别仅解决文字转写,面对方言、口音、专业术语、同音歧义很容易出错。StepAudio3 ASR融合高精度识别与大模型理解能力,从“辨认声音”升级为“读懂语境”。
支持中英、方言、中英混说、长音频与多专业场景识别,能够妥善处理低声、快语速、连读、歌声、背景音乐等复杂环境。针对医疗、法律、金融、汽车、编程等领域,对人名、地名、专业名词识别效果显著优化。
在 Artificial Analysis 非流式语音识别准确性评测,该模型词错误率WER低至1.7%,并列全球第一,适合会议纪要、字幕生产、智能客服、车载交互、医疗记录等场景。
StepAudio3 TTS:还原真人表达细节,不止机械朗读
StepAudio3 TTS主打真人级语音生成,不再局限于文字朗读。模型在音色基底、语调起伏、停顿气口上贴近人类口语,能够还原笑声、迟疑、改口、重复等真人交流里的副语言特征。模型可以结合语义自主调整情绪与语气,搭配流式生成架构,满足实时语音交互场景使用。
StepAudio3 Gen:一站式生成人声、音效、环境音、背景音乐
传统音频制作需要分开生成配音、环境音效、背景音乐,再剪辑混音。StepAudio3 Gen将整套流程整合进单一模型。
依靠自然语言或者参考音频输入,可一次性生成多角色人声、音效、环境声与配乐。支持精细调控多个人物音色、口音、情绪、喘息、停顿等细节,还能定义各类声音事件出现的时间顺序。
影视、动画、游戏、广播剧、有声书、短视频创作者,可以直接描述剧情场景,一次性产出带时序设计的完整音频片段,大幅缩减后期剪辑工作量。
StepAudio3 Music:面向创作者的交互式音乐生成模型
区别于简单一句话生成歌曲的模式,StepAudio3 Music支持交互式音乐创作。用户可以输入歌词、清唱片段、参考曲目、ABC乐谱,让模型基于已有素材继续编曲、改编。
支持写歌、清唱自动配乐、歌曲翻唱,能用自然语言控制曲风、乐器、旋律、段落情绪。模型对主歌、副歌、桥段等歌曲结构建模,保证整首作品旋律连贯、层次完整。其中清唱配乐是一大亮点,上传一段清唱,模型识别旋律节奏情绪,自动匹配和声、乐器与完整编曲。
核心总结
StepAudio3系列的思路,是把语音识别、实时对话、语音合成、多轨音频生成、音乐创作整合为一套完整音频能力栈。多项权威第三方测试登顶,不再单一比拼单项指标,重点强化理解、情绪感知、时序编排、多轮交互等贴近真实音频创作与人机对话的能力。面向开发者,整套模型已经上线阶跃星辰开放平台可调用。
© 版权声明
文章版权归作者所有,未经允许请勿转载。