想要在本地训练 MiniMax H3、Krea 2、Flux‑2 Klein 9B 的视频/图像LoRA,又被高显存门槛、训练失败、LoRA训练完成后角色漂移、效果崩坏等难题困扰?开源工作台 Fizgig 给出了完整解决方案。最新5.0版本更是迎来重磅升级,16GB显存显卡就可以完成33B MiniMax‑H3、12.9B Krea‑2基础模型的全量微调,不再局限于低秩LoRA适配器训练。
- GitHub:https://github.com/shootthesound/Fizgig
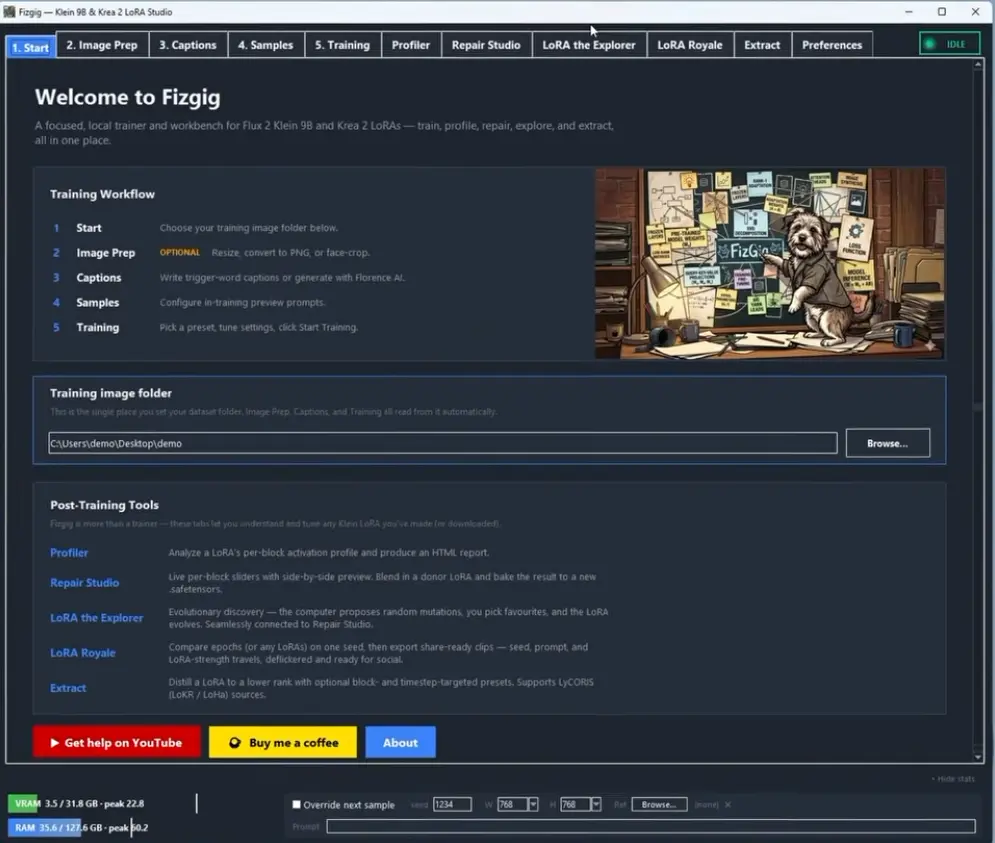
Fizgig 是一款面向 Flux 2 Klein 9B、Krea 2、MiniMax‑H3 的一站式训练工作台,集训练、微调、修复、探索、分析能力于一体。它最大的特色不止是训练LoRA,更提供了一整套LoRA后期加工工具:坏掉、过拟合、风格崩坏的LoRA无需从头重训,即可逐区块滑块修复;几秒之内混音生成全新变体。软件完全免费开源,产出的LoRA文件可直接导入ComfyUI使用。
版本更新历程速览
Fizgig 5.0|全量微调正式上线(最新)
历史性更新,消费级显卡最低16GB显存支持基础模型全秩微调。
- 无适配器、无秩瓶颈:直接更新基础模型权重,从根源修改模型认知,而非用LoRA滤镜修改输出结果
- 自动显存规划器:自动检测空闲显存,动态分配训练窗口,适配你的硬件规格
- 支持照片、语音、短视频片段全类型微调素材
- 内置检查点转LoRA工具,微调完成后导出轻量化、可分享的LoRA权重
- 当前仅支持NVIDIA显卡
Fizgig 4.3.1
社区实测验证 RTX 5070(12GB显存)稳定训练MiniMax‑H3 LoRA,修复显存溢出崩溃;字幕生成进程独立运行,不再拖慢训练速度。
Fizgig 4.3
新增 AMD ROCm训练支持,Windows一键安装包上线;16GB显卡身份蒸馏训练方案落地;修复工作室新增并排对比预览;加入韩语社区语言支持。
Fizgig 4.2
工作台工具全面开放适配MiniMax‑H3,产出业界首份H3 Transformer区块图谱;新增优化相似度学习功能,人物训练效果大幅提升,减少变形问题;追加Whisper离线语音转录功能。
Fizgig 4.0
视频、音频、语音训练功能正式落地。配套预处理工具 Gizmo,自动切割长视频、录制语音数据集;16‑24GB显卡借助int8量化+区块交换实现高速训练。
云端方案:无本地高性能显卡,可使用RunPod一键云端部署模板,训练结束自动关机,避免闲置扣费。
五大工作台核心工具(全部兼容H3 / Krea2 / Klein9B)
1. Repair Studio|LoRA修复工作室
最核心的特色功能。你可以单独调节模型每一个Transformer区块权重,拖动滑块实时预览效果,修复训练失败、过拟合、人脸崩坏、风格跑偏的LoRA,无需重新训练。
- Turbo预览缓存技术,后期区块编辑重绘速度最高提升97%
- 支持跨LoRA区块混合,将A LoRA的身份特征和B LoRA的风格自由拼接
- 并排对比预览窗口,实时查看修改前后差异,导出ComfyUI可用的safetensors文件
2. LoRA the Explorer|进化探索器
变异进化式LoRA生成工具。软件自动生成4组LoRA变体,你挑选最优版本作为新基线;冻结满意区块,调整构图漂移强度,快速探索全新风格,修改成果一键跳转修复工作室二次编辑。
3. LoRA Royale|最优轮次筛选器
批量渲染训练所有轮次结果,固定种子生成对比序列,拖动交叉淡入滑块找到效果最佳的训练快照。可开启ArcFace相似度评分自动定位人物效果最好的轮次;还能导出轮次演变视频、种子漫游循环GIF。
4. Profiler|区块分析器
生成可视化HTML分析报告,精准定位哪一些Transformer区块存储人物身份、画面风格、细节纹理,让你后续修改、训练区块选择有据可依。报告可被修复工作室读取,提供区块彩色标注提示。
5. Extract|权重蒸馏工具
将任意现成LoRA降秩轻量化;支持SVD纯权重蒸馏、激活加权蒸馏两种模式,兼容PEFT、LyCORIS格式的外部LoRA文件。
三大模型生态详细介绍
一、Krea 2(12.9B图像模型)
最低 8GB显存 即可训练完整LoRA,自动显存调度器会根据空闲显存选用INT8/NF4/FP8量化与区块交换策略。
训练器自带独有的数据集智能优化能力,训练过程中自动排查坏样本:
- 检测问题图像,标记字幕‑图片不匹配素材
- 单张图片自适应学习率,防止坏样本带偏整个训练集
- 自动重生成卡住图像的字幕,两次失败后临时跳过样本
- 大角度、侧脸等稀有镜头预热降速训练,保障人物完整
支持LoKR训练、暂停恢复训练,产出文件直接兼容ComfyUI。
二、MiniMax‑H3(33B视频音频模型)
支持照片、短视频片段、人声录音三类素材混合训练同一个LoRA,训练完成的权重完美适配ComfyUI‑H3视频生成工作流。
显存自动分配策略(Auto模式)
| 空闲显存 | 训练方案 |
|---|---|
| ~30 GB | int8、无区块交换、最高1MP分辨率 |
| ~22 GB | int8、14个区块流式加载 |
| ~15 GB | int8、36个区块流式加载 |
| ≤12 GB | 4‑bit量化 |
附带三套官方训练预设:Fast快速训练、慢速高画质训练、纯风格训练预设。
优化相似度学习(默认开启):照片素材仅训练身份区块,视频音频训练全模型,实测人物面部更锐利、提示词遵循度更强,大幅减少预览变形。
素材预处理工具‑Gizmo
训练视频、语音素材前,所有片段必须严格符合H3时长、帧率标准。Gizmo一站式完成素材加工:
- 长视频自动场景切割,导出24fps合规短视频片段
- 波形编辑器裁剪语音音频,Whisper一键生成字幕
- 内置语音录制功能,十分钟朗读录音即可生成一套语音数据集
- 一键静音视频片段,训练画面但不学习声音特征
视频片段标准:24fps,帧数只能为 5 / 22 / 39 / 56 / 73 / 90 / 107 / 124帧
语音片段标准:时长严格匹配 0.917 / 1.625 / 2.333 / 3.042 秒等档位
三、全量微调|跳出LoRA低秩限制(实验性功能)
普通LoRA属于适配器,相当于在冻结的基础模型上叠加一层滤镜,不同概念特征容易互相冲突。全量微调直接修改基础模型本身权重,深度植入人物、世界观、场景概念,训练结束后还可以在微调后的底模之上继续训练LoRA。
旋转可训练窗口技术是低显存微调的核心:任意时刻仅有一小部分模型区块参与训练,冻结区块以4‑bit形式从内存流式加载,bf16主副本常驻CPU内存。
消费级显卡微调参考上限
| 显卡显存 | Krea‑2照片 | H3照片 | H3人声 | H3视频(实测) | H3视频‑仅身份区块(预期) |
|---|---|---|---|---|---|
| 16GB | ✅ | ✅ | ✅ | ✅最高2.3秒 | 最高3.8秒 |
| 24GB | ✅ | ✅ | ✅ | ✅最高2.3秒 | 最高5.2秒 |
| 32GB | ✅ | ✅ | ✅ | ✅最高3.8秒 | 最高5.2秒 |
注意:12GB显卡仅支持LoRA训练,无法进行基础模型全量微调。
© 版权声明
文章版权归作者所有,未经允许请勿转载。