在大模型训练与推理场景中,内存带宽早已成为制约AI芯片性能释放的核心瓶颈。英伟达近日为 NVLink Fusion 计划新增了一项关键硬件组件 NVHBM,一款深度定制的高带宽内存基底芯片,专供生态合作伙伴打造自研加速器芯片使用。
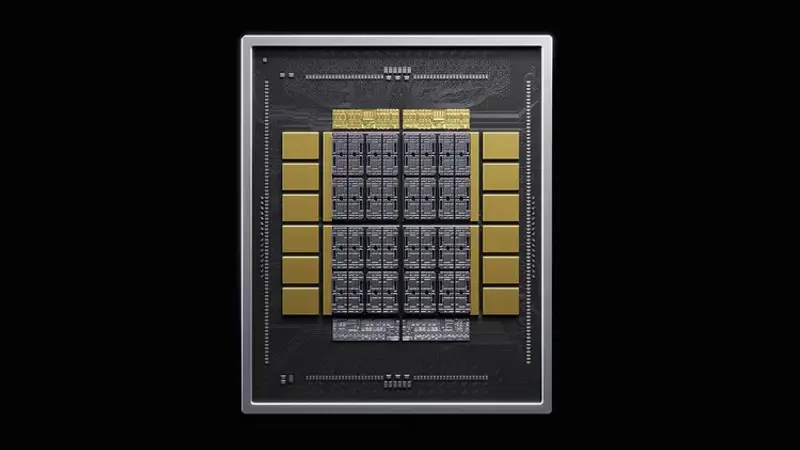
NVLink Fusion 是英伟达面向合作伙伴开放的互连技术方案,目标是把多颗独立处理器通过 NVLink 高速总线,组合成一台大型一致性计算集群,Vera Rubin NVL72 机架级加速器正是这套生态下的代表产品。而 NVHBM 的加入,补齐了整套方案里内存侧的重要一环。
NVHBM是什么,和普通 HBM4e 有什么区别
NVHBM 并非一款用来直接替代市面 HBM4e 的通用内存产品。它是英伟达联合头部内存厂商共同设计验证、仅向 NVLink Fusion 合作伙伴开放的定制化 HBM 基底芯片方案。
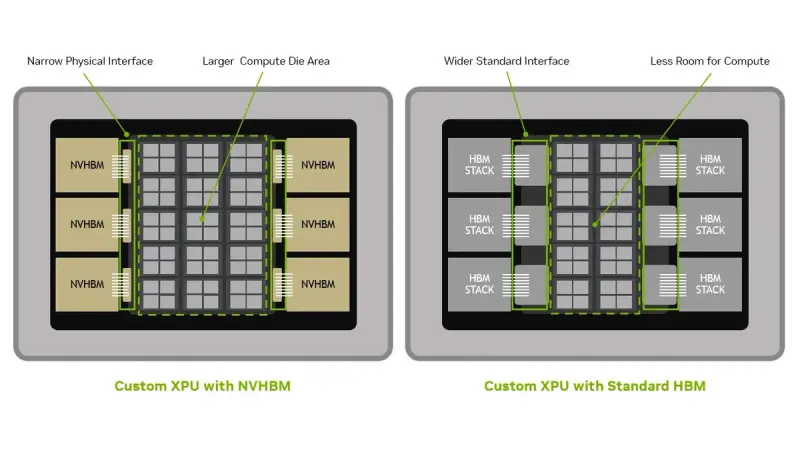
传统设计里,HBM 的内存控制器集成在主加速器芯片之上;而 NVHBM 将内存控制器搬迁至 HBM 堆栈内部的基底芯片,再对外提供一枚体积更小的定制 PHY 交由客户集成。
这种架构改动带来三大核心收益:
- 带宽提升30%:相较于商用版 HBM4e,NVHBM 单个内存堆栈带宽最高提升 30%。对于带宽受限的AI推理、大模型KV‑缓存读写任务,可以直接拉高 token 吞吐速度。
- 功耗降低15%:同等条件下内存堆栈功耗相比 HBM4e 下降15%。省下的功耗预算既可以给到更多计算核心,也能够在整机功耗上限不变时拉高持续运行性能。
- 释放主芯片宝贵的硅片面积:主芯片不再需要布置大面积的内存控制器电路,空余出来的区域最多可以增加 30% 的计算单元。同时该方案也简化了先进封装当中中介层的布线复杂度,降低多芯片互连的设计难度。
对于大规模机架集群而言,带宽提升、功耗降低的收益会在数千颗芯片规模下成倍放大。原本消耗在数据搬运上的电力,就可以转而投入到模型运算当中,改善整个数据中心的能效表现。
需要注意:目前公布的带宽、功耗增益都属于方案设计指标,Vera Rubin 当前已发布的机架系统暂未搭载 NVHBM。
首个落地合作伙伴:亚马逊 Annapurna Labs
英伟达官宣亚马逊旗下 Annapurna Labs 成为 NVHBM 的首位合作方。
Annapurna Labs 的下一代 Trainium 4 AI 芯片原生搭载 NVLink Fusion 扩展接口,双方的合作预示 AWS 未来自研基础设施芯片很有可能接入 NVHBM 定制内存方案,进一步提升云端AI算力集群的性能上限。
站在产业视角来看,NVHBM 的推出意味着英伟达正在从单纯销售GPU,转向输出一整套包含高速互连总线、定制内存、封装参考方案在内的完整芯片开发工具包,吸引云厂商、大型企业基于 NVLink 生态打造自己的AI加速器,构建起一个更大的硬件同盟。
© 版权声明
文章版权归作者所有,未经允许请勿转载。