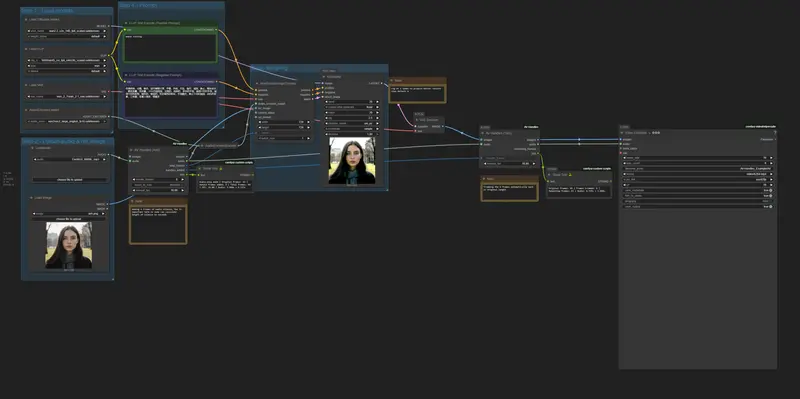
ComfyUI MiniMax H3-Promptor 是一套专为 MiniMax H3 视频生成系统设计的节点化工作流工具,通过解耦架构将多模态视觉分析与文本提示词结构化分离。其核心由 H3_Vision_Analyzer 和 H3_Promptor 两个节点组成,前者负责基于 JSON 预设的图像/视频内容解析,后者接收纯文本上下文生成符合 H3 格式的影院级提示词。该设计避免重复调用 VLM 分析媒体,显著降低 API 成本,同时支持 OpenAI、Ollama、Gemini、Claude 四家提供商的原生集成,所有配置与扩展均通过本地文件完成,无需修改代码。
- GitHub:https://github.com/1038lab/ComfyUI-MiniMax-H3-Promptor
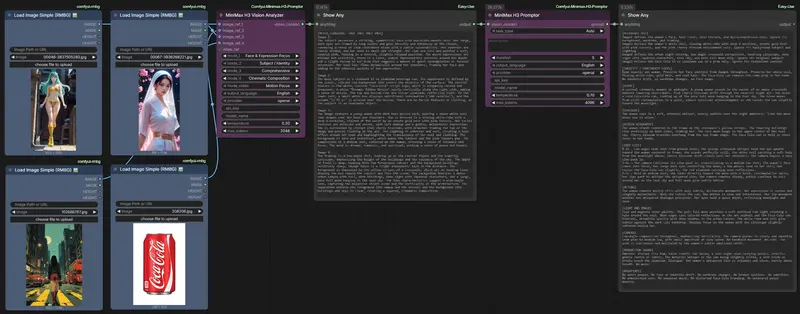
双节点协同机制与模式自动识别
工作流的核心优势在于职责分离与智能联动:
H3_Vision_Analyzer(视觉分析引擎)
- 支持 4 张图像 + 1 批视频关键帧(最多提取 4 帧)并行分析
- 每个媒体槽绑定独立分析模式,从
vision_prompts.json动态加载预设(如仅角色、仅光照、全构图) - 输出结构化
vision_context文本,并嵌入隐藏[MEDIA_SIGNATURE]标记输入组合 - 温度默认 0.2,确保事实描述精确性;支持中英双语输出
H3_Promptor(提示词结构引擎)
- 接收用户创意描述 + Vision Analyzer 的文本报告,不直接处理图像张量
- 静默解析
[MEDIA_SIGNATURE]自动选择生成模式:- 无媒体 → T2V
- 1 图 → I2V
- 2 图 → FL2VA(首尾帧)
- 3–4 图或图+视频 → Ref2VA(Omni 参考)
- 仅视频 → V2V
- 时长参数(4–15 秒)驱动镜头列表严格对齐 24FPS 时间轴
- 温度默认 0.7,适配创意写作需求;输出语言可选简体中或英文
两节点间仅传递文本与签名,图像数据在 Analyzer 阶段即被消费完毕,Promptor 可脱离媒体连接独立运行,便于复用分析结果或调试提示词结构。
LLM 提供商集成与配置管理
四家提供商均为原生 API 实现,无中间兼容层,各自独立维护:
| 提供商 | 认证方式 | 默认模型 | 多模态支持 |
|---|---|---|---|
| OpenAI | Bearer Token | gpt-4o | ✅ |
| Ollama | 无需认证(本地) | llama3.1 | ✅ |
| Gemini | URL ?key= 参数 | gemini-2.5-flash | ✅ |
| Claude | x-api-key Header | claude-sonnet-4-20250514 | ✅ |
配置优先级:节点 UI 覆盖 > config.json > 默认值。首次加载自动生成 config.json,格式如下:
{
  "providers": {
    "openai":  { "api_key": "sk-..." },
    "gemini":  { "api_key": "AIza..." },
    "claude":  { "api_key": "sk-ant-..." }
  }
}
Ollama 无需密钥,适合离线或隐私敏感场景。所有提供商均支持 Vision Analyzer 的图像输入,但需注意各模型对多图/视频帧的处理能力差异。
自定义扩展路径与模板体系
vision_prompts.json 扩展
首次启动自动生成该文件,结构为键值对形式的分析策略库:
{
  "image_prompts": {
    "Subject / Identity": "Focus exclusively on describing the main subject's appearance...",
    "Color Palette & Texture": "Focus exclusively on the dominating colors..."
  }
}
新增自定义键后重启 ComfyUI 即可在下拉菜单中使用。建议按分析维度分类命名,避免语义重叠导致输出混淆。
系统模板定制
templates/ 目录控制最终提示词的格式化逻辑:
system_base.txt:定义全局规则与通用约束t2v.txt/i2v.txt/fl2va.txt/ref2va.txt/v2v.txt:各模式专属结构模板
修改模板不影响节点逻辑,仅改变输出格式。建议备份原始文件后再编辑,错误模板可能导致 H3 解析失败。模板变量占位符需保持与 Promptor 内部渲染逻辑一致,否则字段无法填充。
安装部署与使用注意事项
- 克隆仓库至
ComfyUI/custom_nodes/Comfyui-Minimax-H3-Promptor - 执行
pip install -r requirements.txt安装依赖 - 首次加载节点触发
config.json生成,填写所需 API 密钥 - 若使用 Ollama,确保本地服务已启动且模型已拉取
关键注意点:
- Vision Analyzer 的温度 0.2 适用于客观描述,若需创意解读可手动调高,但可能牺牲一致性
- Promptor 的 Auto 模式依赖签名解析,手动指定 task_type 可绕过自动检测,适用于签名丢失或调试场景
- 视频关键帧提取数量固定为 4,长视频建议预先截取代表性片段再输入
- 中文输出时注意术语统一,避免中英混杂影响 H3 理解
- API 密钥存储在本地 config.json,勿提交至版本控制系统
该套件适合需要高频、低成本生成结构化提示词的工作流,尤其利于批量制作或迭代测试。对于单次创作,直接使用官方提示词指南可能更高效;但对于规模化生产,其解耦架构带来的成本节约与灵活性具有明确价值。
© 版权声明
文章版权归作者所有,未经允许请勿转载。