SK海力士、TetraMem与南加州大学的研究人员共同展示了一款基于忆阻器(Memristor)的存内计算(IMC)系统级芯片(SoC)。这款实验性芯片旨在为边缘AI设备提供极高的能效,但其实际性能表现仍笼罩在理论数据的迷雾中。
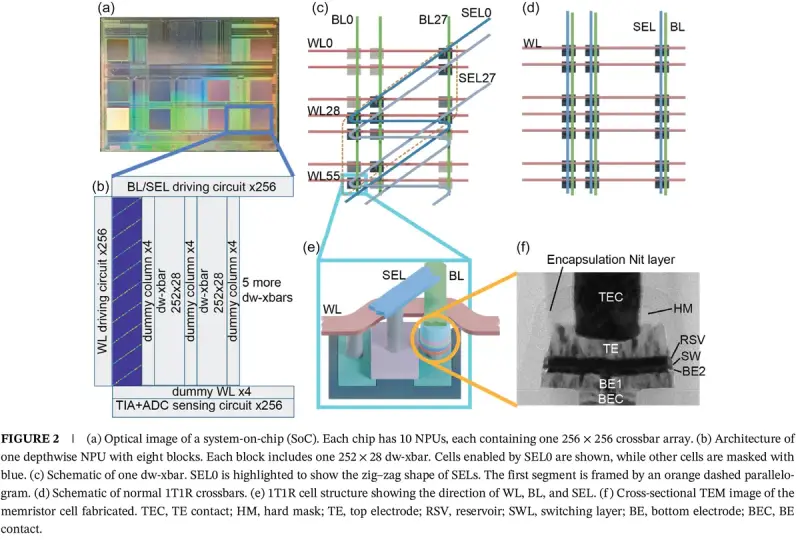
核心架构:专为深度卷积优化
传统的存内计算交叉开关阵列在处理深度卷积(DWC)时效率低下,因为DWC的数据重用率低,难以充分利用阵列。为解决这一痛点,研究团队设计了一种混合架构:
- 10个神经处理单元(NPU):SoC内置一个嵌入式RISC-V处理器进行调度,并配备10个NPU。
- 专用DWC NPU:其中一个NPU经过特殊优化,采用“之字形”拓扑结构的252×28交叉开关块。这种设计允许28个独立的3×3卷积并行运行,实现了100%的阵列利用率,专门加速轻量级网络中的核心操作。
- 9个通用NPU:其余九个NPU保留传统的1T1R交叉开关结构,负责执行逐点卷积和密集层运算。每个NPU包含256×256的忆阻器阵列,以及用于数模/模数转换的DAC和ADC。
精度突破:从2位到4位的跨越
忆阻器器件通常只能以略高于2位的精度进行编程,这限制了其在高精度AI任务中的应用。团队采用了一种双子阵列补偿技术,通过两个编程子阵列来抵消模拟编程误差,从而将有效权重精度提升至约4位。
在Visual Wake Words基准测试中,部署定制的MobileNetV1Small模型后,该SoC实现了**80.36%**的端到端推理精度,与相应的4位软件模型相当。这在概念上类似于英伟达的NVFP4,但实现路径截然不同:前者依赖数字浮点缩放,后者依赖模拟硬件补偿。
能效亮眼,性能存疑
数据显示,该芯片在100MHz频率下能效高达21.3 TOPS/W,在400MHz时为11.9 TOPS/W。论文声称,即便使用较旧的65nm工艺,其INT8能效也比英伟达A100高出一个数量级。
然而,这些亮眼数据背后隐藏着巨大的不确定性:
- 理论峰值仅为2.54 TOPS:这是基于10个NPU全部饱和的理想计算值。相比之下,微软Copilot+ PC的NPU要求至少为40 TOPS,这意味着该芯片的性能仅为其1/16。
- 演示未满载:在基准测试中,仅使用了1个DWC NPU和5个通用NPU,其余4个处于空闲状态。论文未披露所有10个NPU是否能同时饱和工作,也未提供真实网络下的持续吞吐量数据。
- 对比基准模糊:与A100的能效对比缺乏详细的测试条件说明,使得“高出一个数量级”的说法难以直接验证。
这款SoC无疑是一次重要的概念验证。它证明了通过架构创新,忆阻器存内计算可以在低精度硬件上实现可用的AI推理精度,并在能效上展现出巨大潜力。
但对于急于寻找GPU替代方案的边缘设备制造商而言,2.54 TOPS的峰值性能和未经充分验证的多核并行能力,意味着距离大规模商业化应用仍有漫长的路要走。它更像是一份指向未来的技术路线图,而非即刻可用的解决方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。