智象未来 HiDream-O1-Image-1.5 登顶全球文生图榜第二,仅次于 OpenAI;基于原生全模态 UiT 架构,在文字渲染、复杂排版及多主体控制上实现突破
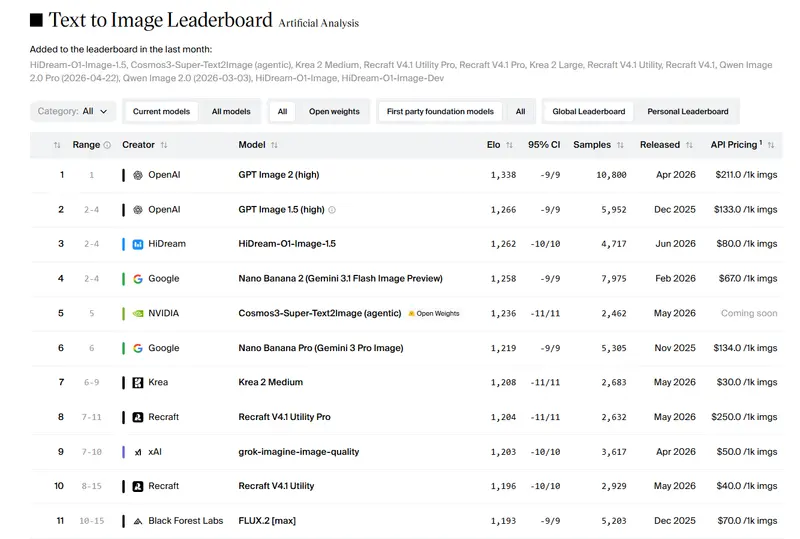
在全球 AI 图像生成领域,智象未来(HiDream.ai) 推出的商用版模型 HiDream-O1-Image-1.5 取得了里程碑式的突破。在权威独立评测平台 Artificial Analysis 的文生图榜单中,该模型以 1265 ELO 的高分位列全球第二,综合表现仅次于 OpenAI,超越了众多国际顶尖竞品。这一成绩不仅印证了其卓越的技术实力,更标志着中国 AI 企业在高端商业视觉生成赛道上已具备全球领先的竞争力。
核心亮点:原生全模态、高精度、强可控
1. 权威评测认可,实力位居前列
- 全球第二:在 Artificial Analysis 基于匿名对比和用户投票的 ELO 动态排名中,HiDream-O1-Image-1.5 在超过 4000 个样本对比中脱颖而出。
- 开源商用双优:此前,其开源版本 HiDream-O1-Image-Dev-2604 已拿下开源模型全球第一;此次商用版的优异表现,进一步证明了其技术架构在不同规模下的可扩展性与稳定性。
2. 革命性架构:Unified Transformer (UiT)
- 打破模态壁垒:不同于传统“文本编码器 + VAE + 扩散模型”的模块化拼凑,UiT 架构从底层将图像像素、文本 Token、视频体素等原始信号映射进同一个共享 Token 空间。
- 端到端推理:由同一套 Transformer 完成理解、生成与推理,消除了不同模块间信息转换带来的细节损耗与语义错位。
- 原生全模态:真正实现了像素级的原生全模态融合,为处理复杂任务提供了坚实的底层基础。
3. 商业级生成能力
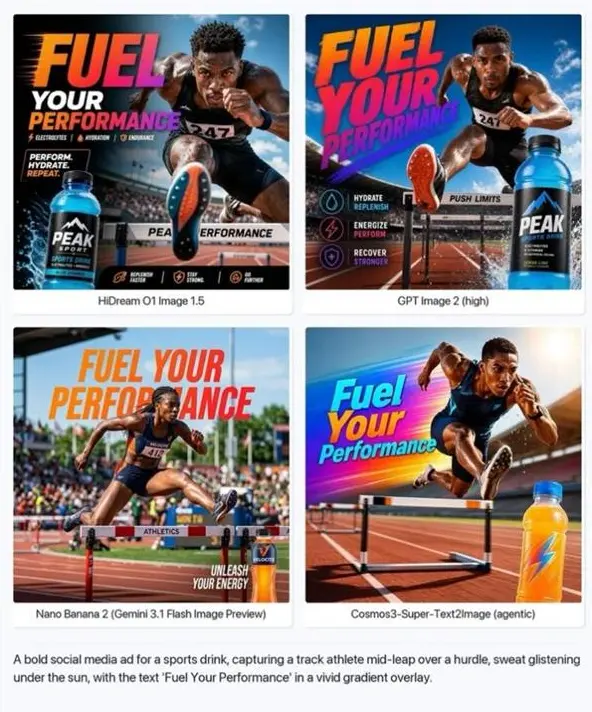
- 精准文字渲染:解决了长期以来 AI 绘图“乱码”的痛点,能在图像中生成清晰、准确的指定文字,适用于海报、Logo 设计。
- 复杂排版与多主体控制:在处理多个人物、物体共存且需保持身份一致性的场景下表现卓越,支持复杂的画面布局与视觉叙事。
- 高语义遵循:对提示词的理解更加深刻,能精确还原用户描述的细节、光影及空间关系。
技术愿景:迈向原生全模态世界模型
HiDream-O1-Image-1.5 的成功不仅是图像生成的胜利,更是智象未来构建原生全模态世界模型的重要一步。其理念认为,图像是现实世界某一时刻的主体、空间、材质、光影与关系的载体。只有稳定理解并生成这些静态状态,模型才能进一步处理连续时间中的运动、因果、镜头语言和长视频叙事。
UiT 架构的可扩展性,为后续的多图一致性、视频首帧生成乃至长视频生成奠定了更稳定的底层能力,预示着 AI 将从“单帧绘画”向“动态世界模拟”演进。
© 版权声明
文章版权归作者所有,未经允许请勿转载。