Together AI
Together AI 都提供了一套完整的工具和服务,帮助你更高效地构建、优化和部署生成式AI应用。Together AI 的核心产品是 AI 加速云 ,旨在为用户提供生成式AI从开发到部署的端到端解决方案。
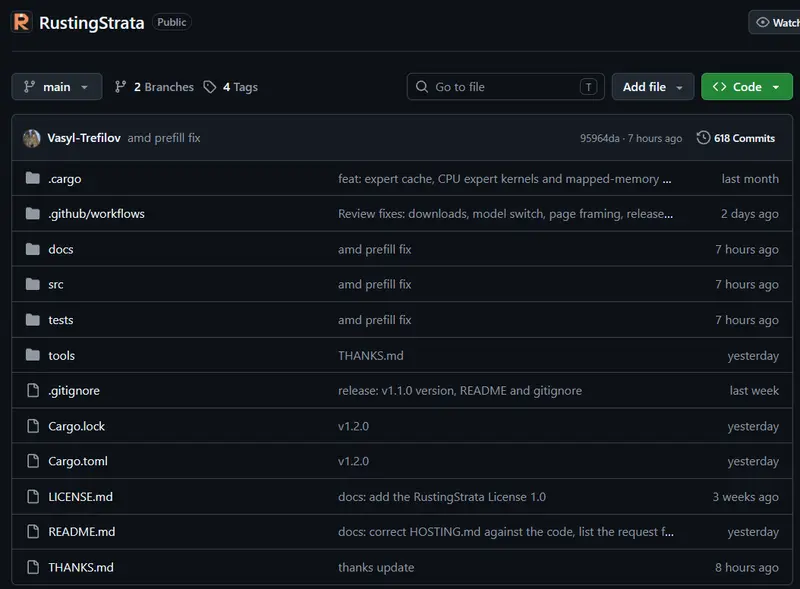
RustingStrata 是一款纯 Rust 编写的 GGUF 推理引擎,主打适配 Qwen 新一代混合专家模型家族,包括 Qwen3.5/3.6 MoE、Qwen3-Next、Qwen3.8-Flash-Next、Qwen3 稠密与MoE版本,不依赖 ggml、没有C++编译链路,CUDA内核依靠 cudarc + NVRTC 运行时...
 RustingStrata
 是一款纯 Rust 编写的 GGUF 推理引擎,主打适配 Qwen 新一代混合专家模型家族,包括 Qwen3.5/3.6 MoE、Qwen3-Next、Qwen3.8-Flash-Next、Qwen3 稠密与MoE版本,不依赖 ggml、没有C++编译链路,CUDA内核依靠 cudarc + NVRTC 运行时编译并缓存cubin;同时支持Vulkan后端,GLSL编译为SPIR-V执行。
核心特色:MoE专家动态放置,放不下显存的专家自动放到CPU,和GPU专家并行协同推理,根据推理路径实时调整专家分配。当前版本 v1.2.0,M0~M6里程碑全部完成,内置聊天、校准、基准测试、服务化能力。
同时支持大量量化格式:F32/F16/BF16、Q8_0、Q2_K~Q6_K、IQ1_S/M、IQ2/3/4系列等,覆盖Qwen各尺寸稠密、MoE模型。
cargo build --release直接运行二进制,默认拉起 WebUI 聊天页 http://127.0.0.1:8080,内置模型下载、显存/内存监控、对话缓存;
同时兼容两套API:
/v1/chat/completions,可对接 Open WebUI、SillyTavern、各类代码编辑器;--parallel N)。calibrate:自动校准模型最优预填充块、MTP参数,结果缓存json;generate:单次生成;chat:交互式对话;bench:基准测速;serve:后台API服务,支持API密钥、反向代理部署。--kv q8 将KV缓存占用减半,小幅牺牲速度;--device 0,1,按剩余显存比例分配层,优先把更多专家留在显存;--cache-ram 缓存会话状态,长智能体对话避免重复预填充;支持保留思考块,适配Qwen3.6思考模板;