Agnes AI
Agnes AI正通过一项激进的策略在全球 AI 市场中崭露头角:将高性能的多模态模型 API 无限期免费开放给全球开发者和创作者。自 2026 年 6 月 1 日起,Agnes AI 的核心模型家族——涵盖文本、图像和视频——正式向公众敞开大门,旨在降低高质量 AI 的使用门槛,并推动其在各类产品中的无缝集成。
FreeLLMAPI 是一个开源的本地网关项目,它将来自 Google、Groq、Cerebras、NVIDIA、Mistral 等 11 家主流服务商的免费额度聚合到一个统一的 /v1/chat/completions 端点中。通过智能路由和自动故障转移机制,FreeLLMAPI 为你提供了每月约 10 亿+ Token 的有效推理容量...
 FreeLLMAPI
在各大 AI 实验室纷纷提供免费额度的今天,单个服务的限额往往显得捉襟见肘。FreeLLMAPI 是一个开源的本地网关项目,它将来自 Google、Groq、Cerebras、NVIDIA、Mistral 等 11 家主流服务商的免费额度聚合到一个统一的 /v1/chat/completions 端点中。
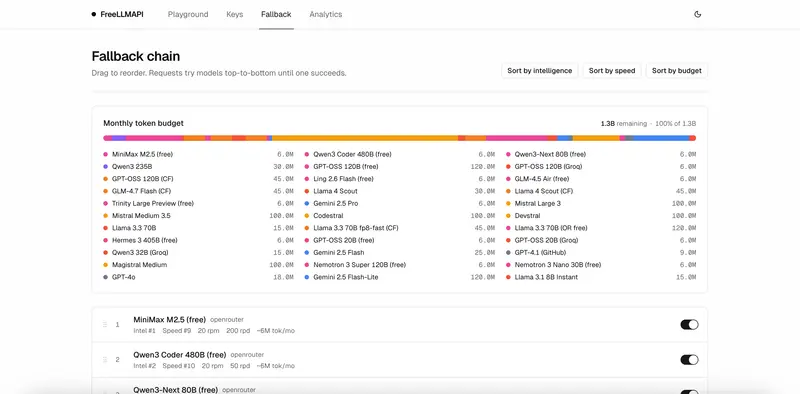
通过智能路由和自动故障转移机制,FreeLLMAPI 为你提供了每月约 10 亿+ Token 的有效推理容量,让开发者能够以零成本享受从快速轻量到高性能模型的多样化服务。
FreeLLMAPI 整合了以下平台的免费层级:
freellmapi-... 令牌即可访问所有后端服务,无需在代码中硬编码多个密钥。内置基于 React + Vite + shadcn/ui 的管理界面,方便用户:
# 克隆仓库
git clone https://github.com/tashfeenahmed/freellmapi.git
cd freellmapi

# 安装依赖
npm install

# 生成加密密钥并创建 .env 文件
cp .env.example .env
echo "ENCRYPTION_KEY=$(node -e "console.log(require('crypto').randomBytes(32).toString('hex'))")" >> .env

# 启动开发服务器(包含前端仪表板)
npm run dev
http://localhost:5173。npm run build
node server/dist/index.js
注:支持在 PM2 下运行,甚至可以在树莓派上轻松部署。
FreeLLMAPI 完全兼容 OpenAI SDK,只需修改 base_url 和 api_key 即可无缝接入现有项目。
from openai import OpenAI

client = OpenAI(
    base_url="http://localhost:3001/v1",
    api_key="freellmapi-your-unified-key",
)

# 使用 "auto" 让路由自动选择模型,或指定具体模型如 "gemini-2.5-flash"
resp = client.chat.completions.create(
    model="auto",
    messages=[{"role": "user", "content": "用一句话概括罗马帝国的衰落。"}],
)

print(resp.choices[0].message.content)
# 查看请求实际路由到了哪个服务商
print("Routed via:", resp.headers.get("x-routed-via"))
FreeLLMAPI 是一个极具创意的“薅羊毛”利器,它通过技术手段将分散的免费资源整合成一股强大的合力。对于个人开发者、学生或小型初创团队而言,它提供了一个零成本、高可用性的大模型接入方案。