Free Model Radar
Free Model Radar 是一个轻量级、实时的监控工具,旨在帮助开发者和研究者追踪各大 AI 厂商免费模型的可用性、速率限制及性能表现。它部署在 Cloudflare Workers 上,利用其边缘计算能力和 KV 存储,以极低的成本实现高频次的模型探针检测。
SubQ Snap公开预览版最高支持384K token图文输入,是Jev 32K上下文上限的12倍,处理100K token输入可在1秒内输出决策,AI智能体无需对大型代码库、交互历史频繁分块。
 Subquadratic
推出SubQ Snap决策模型,入局火热的决策模型赛道。TypeSafe的Jev引爆这一领域,OpenAI、Perplexity、Cloudflare、亚马逊、微软等厂商都陆续推出同类产品。
SubQ Snap公开预览版最高支持384K token图文输入,是Jev 32K上下文上限的12倍,处理100K token输入可在1秒内输出决策,AI智能体无需对大型代码库、交互历史频繁分块。
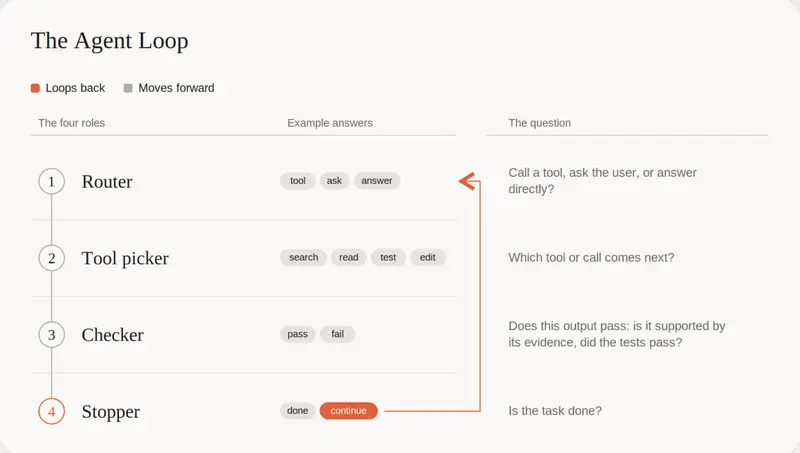
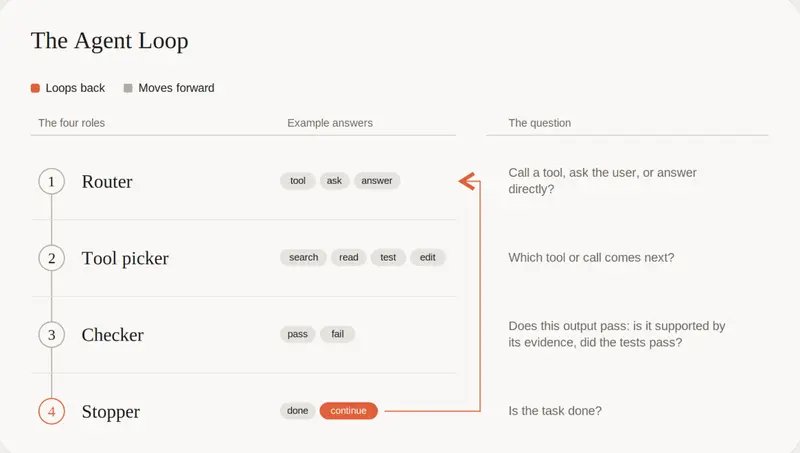
决策模型和传统LLM本质不同:不生成文本代码,只在预设候选结果中做选择,例如选定工具、筛选文件、判断测试结果。Workday已经使用Jev,为Sana AI助手根据员工需求挑选UI组件,这类高频判断交给专用模型,能够降低昂贵大模型的调用开销。
Subquadratic CEO Alex Whedon表示Snap的研发受到Jev启发,决策模型省去token解码环节。但他认为当下决策模型大多只承担LLM的辅助事务,真正的价值是从前沿LLM手中承接核心工作。
现有决策模型受限于上下文长度,处理大型代码库bug排查时,往往需要舍弃潜在关键信息,或者切换到大模型。Snap依靠自研SSA稀疏注意力架构,注意力开销随上下文长度线性增长,突破传统Transformer二次方算力瓶颈。
内部基准测试显示,Snap在RULER长上下文测试32K~100万token区间得分稳定在96.3 ~99.8;跨文档推理任务Decision LCR拿到74.0分,Jev为48.0。短任务场景,Decision Index 0.2.1 Snap得分61.7,高于Jev的57.9;Nimble基准准确率82.9%,Jev为76.0%。16项企业级基准中13项Snap占优,Jev则在When2Call(工具调用判断)3项任务表现更好。
需要留意:全部基准为厂商自测,仅长上下文评测代码开源供复现;384K是公开预览临时上限,模型原生支持100万token,但全开需要2.6倍算力。Snap暂未登上新版Decision Index 0.3.2榜单,新旧版本分数无法直接对比。
超大上下文可以简化AI智能体开发。传统方案需要检索、摘要、分块压缩文本,裁剪过程很容易丢失关键信息。当资料在384K token以内,Snap可直接读取整套文档、代码模块,省去大量分块操作。企业超大规模知识库依然离不开检索,但检索策略可以更加粗放,直接拉取完整文档,不用精细截取片段,减少Agent链路的不稳定点。
定价策略:公开预览阶段,每100万输入token收费0.05美元,输出免费。100K token输入成本约0.005美元,满384K token请求约0.02美元。原因在于决策模型只输出候选概率,计算消耗集中在读取输入,输出成本几乎可以忽略。
Subquadratic前身Aldea,今年5月结束隐身开发,拿到2900万美元种子轮,估值5亿美元。核心团队来自Meta、Tribe AI。此前发布的SubQ模型就主打千万级超长上下文,后续还在研究无注意力机制的全新架构。Snap建立在该团队稀疏注意力积累之上,进军竞争激烈的决策模型赛道。Snap目前的性能优势均来自内部测试,还需要第三方独立验证,才能确认长上下文带来的实际增益。