OpenClaw Master Skills
OpenClaw Master Skills 是MyClaw平台精心策划、每周更新的优质 Skills 合集——从整个生态系统中精挑细选,帮助你的 AI Agent 做更多事。
Lieflat Less AI Tone 是一套经过两轮对照实证研究的去 AI 味 Skill,区别于网上常见的禁用词清单、通用提示词,依靠量化指标定位 AI 写作特征,采用「先出检测报告、用户确认、再改写 + 复测」的工作流,优先避免过度改写、破坏原文信息。
 Lieflat Less AI Tone
 是一套经过两轮对照实证研究的去AI味Skill,区别于网上常见的禁用词清单、通用提示词,依靠量化指标定位AI写作特征,采用「先出检测报告、用户确认、再改写+复测」的工作流,优先避免过度改写、破坏原文信息。
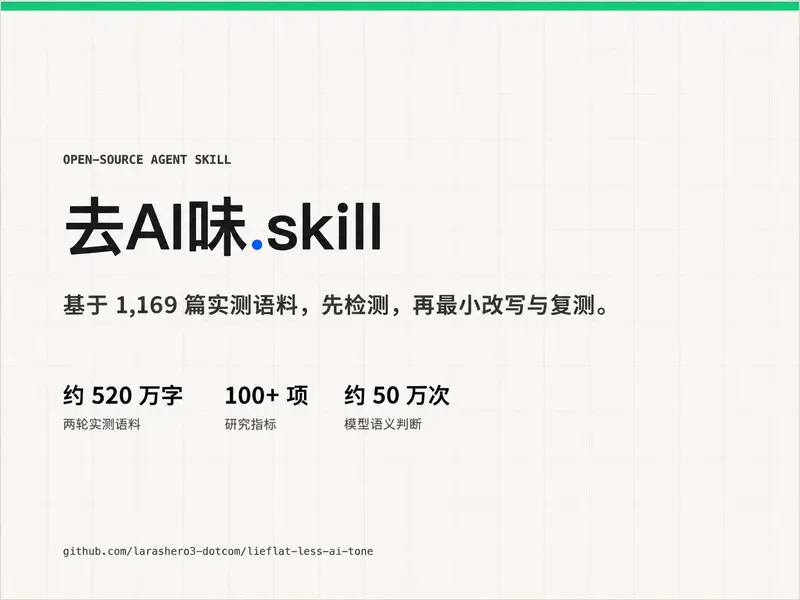
整套研究总语料1169篇、约520万汉字,设计100+指标,语义层完成约50万次封闭式模型判断(Jev结构化判定),分为第一轮跨文本对照、第二轮同事实配对复测,从脚本统计、语义判断、人工标注三层校验特征,只有通过统计显著性门槛的特征才纳入改写规则。
第一轮:629篇对照样本,5个主流大模型(Claude Opus 4.6、DeepSeek V4 Pro、Gemini 3.1 Pro、GPT-5.6 Sol、Kimi K3)生成文本300篇,搭配329篇人类原创文本,用倍率R初步筛选特征,附加组间一致性、可定位、可改写三条约束。
第二轮:270对同事实配对样本,消除话题差异带来的干扰,分为三层测量:
共9项,是改写优先关注项:「不是A而是B」类对举句式、刻意避免词汇重复、段落切分细碎、句长节奏过于均匀、前置长定语、「核心是:」这类结论前置引导、段落衔接过度顺滑、密集并列枚举、比喻生硬违和。
重要修正:原先“概括替代具体信息”特征在配对复测后净差异几乎归零,降级为X级,不再作为改写依据,保障原文事实信息不丢失。
GPT和Claude Opus写作习惯差异明显:GPT偏爱分号串联、缺少单动词短句、少短促收尾句、不爱提问;Opus高频使用破折号、长铺垫后置焦点、“的”字密度更高、引号使用偏少、暗喻使用更多。直接套用同一套改写规则会出错。
段首零回指、相邻句同构属于弱信号;而大家熟知的“赋能、闭环、抓手”黑名单词、“首先其次总之”连接词、编造精确数字,在配对对照下没有统计学差异,证明单纯屏蔽热词几乎无法解决AI味问题。
报告分级:A类可机械修改;B类建议句式重组;C类仅报告、默认不改;H类比喻交由人工审阅;X类已证伪、绝不改动;F类模型专属指纹,按需处理。
改写六条硬性约束:最小改动、信息守恒、不强行制造长短句参差、不随意改动原文结构、可参考风格范本、改写后复测校验,杜绝为了“像人写的”强行打乱原文。
两种使用方式:作为Agent Skill安装,或者本地Python脚本运行,npx skills add larashero3-dotcom/lieflat-less-ai-tone。配套文档:SKILL.md改写规则、DETECT.md检测协议、RESEARCH.md实验复盘记录。
局限:语义层判断存在15%-30%误判;人类写作本身风格离散度极大;模型持续迭代,指标阈值是阶段性观测结果;比喻自然度无法自动化判定。
语料受版权约束不公开,但是统计算子、判定阈值、整套检测脚本全部开放,使用者可以导入自有语料复现整套评测。