Inworld TTS
新一代文本转语音模型Inworld TTS,以市场上最具竞争力的价格提供顶尖的质量和低延迟。旗舰模型 Inworld TTS-1 提供逼真、上下文感知的语音合成以及精准的零样本语音克隆,性能超越领先实验室的同类解决方案。
Prime Intellect 正式发布 Prime Inference,一款面向前沿开源模型的推理服务平台,提供无服务器弹性端点以及跨多数据中心GPU的预留算力。
 Prime Inference
Prime Intellect 正式发布 Prime Inference,一款面向前沿开源模型的推理服务平台,提供无服务器弹性端点以及跨多数据中心GPU的预留算力。公测前内部测试阶段,平台每日处理近万亿Token,负载来源包含RL迭代、合成数据生成、模型评估与长时编码智能体任务。
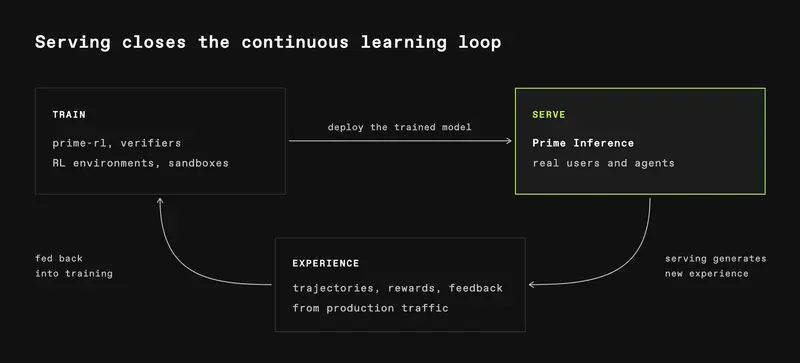
Prime Inference是Prime Intellect整套开源训练栈的服务层。该团队此前已经开源prime-rl、验证器、沙箱等后训练工具;这套推理服务补齐闭环:模型在线服务产生的轨迹数据,可以回流用于模型后续训练。官方称其GLM-5.3端点在OpenRouter上属于速度第一梯队,工具调用错误率接近0,上线至今保持100%可用。
https://api.pinference.ai/api/v1整套推理栈融合NVIDIA Dynamo、vLLM、Mooncake、FlashInfer,联合Inferact与NVIDIA共同开发,相关修复代码已向上游开源项目提交。
平台核心目标场景就是AI智能体:典型智能体一轮对话会在140K上下文提示词基础上新增约6K Token。基准测试使用SemiAnalysis AgentX,并注入冷启动流量做压力验证。
Prefill和Decode跑在独立GPU集群,Dynamo负责流量路由,vLLM承载模型推理。Decoder通过NIXL读取KV缓存,实测p90令牌间延迟下降接近40%。
Dynamo的KV感知路由器会权衡缓存前缀重合度与队列负载,保证同一会话持续绑定到同一个Decoder实例;Mooncake在主机内存增加第二层KV缓存。
平台交互目标:单用户端到端100 token/s。测试证明1:4的prefill/decode配比,能承载最多并发会话,实现单用户101 tok/s,单GPU输出100 tok/s,每组prefill集群支持66路并发会话。
智能体大量失败来自工具调用名称错误、参数损坏。Prime Intellect向Dynamo提交结构标签构建器适配GLM工具格式;vLLM借助xgrammar屏蔽不符合工具Schema的非法Token,同时修复代码内<转义<这类解析Bug。
| 特性 | Prime Inference | Together AI | Fireworks AI | Baseten |
|---|---|---|---|---|
| GLM-5.3无服务器 | ✅ | ✅ | ✅ | ✅ |
| GLM-5.3价格(输入/输出 /1M token) | 文档暂未公布 | $1.40 / $4.40 | $1.40 / $4.40 | $1.40 / $4.40 |
| 预留/专用算力 | 预留容量,一键专用部署在路线图 | 专用端点 | 按需专用GPU | 专用GPU |
| OpenAI兼容API | ✅ | ✅ | ✅ | ✅ |
| 批量推理 | 路线图规划 | ✅ | – | – |
| 可披露底层栈 | Dynamo、vLLM、Mooncake、FlashInfer开源栈 | Together自研推理栈 | Fireworks自研栈 | Baseten自研栈 |
竞品价格数据验证时间:2026-10-02,价格数据来自第三方ComputePrices追踪器