
New API
New API 是新一代 AI 基座平台,为您的 AI 应用提供统一的基础设施。承载所有 AI 应用,管理您的数字资产,连接未来的统一接口平台。
SonicBoom 的核心创新是彻底砍掉 Python 依赖链,构建自带 MLIR 编译层的张量运行时,依托 CUDA Graph 与算子融合提升本地 LLM 解码性能,同时具备通用张量计算能力,不只局限大模型推理。现阶段版本号 v0.0.3,仍属于早期实验版本,仅在 sm_86 显卡完成充分验证,跨 GPU 架构适配还在完善。
 SonicBoom
 是一个从头用 C++ 和 CUDA 编写的 AI 框架,专为性能关键型工作负载设计。它的核心特征非常明确:没有 Python 解释器,没有 pip 依赖树,也没有 wheel 构建产物。整个系统通过稳定的 C ABI 暴露,GNU Guile 作为其一等语言。开发者可以从任何编程语言中直接加载 libsonicboom.so,在推理路径上保持绝对的轻量与纯粹。
SonicBoom 主要面向消费级 GPU 上的本地 LLM 推理。在笔记本 RTX 3050(sm_86)上,使用相同的量化内核,其解码速度比 llama.cpp 快 12% 到 18%。具体而言,在 Gemma 4 E4B-it (Q3_K_M) 上达到 1.18 倍,在 Qwen2.5-0.5B-Instruct (Q4_K_M) 上达到 1.12 倍。预填充阶段在 Gemma 4 上与 llama.cpp 持平,在 Qwen2.5 上领先 9%。
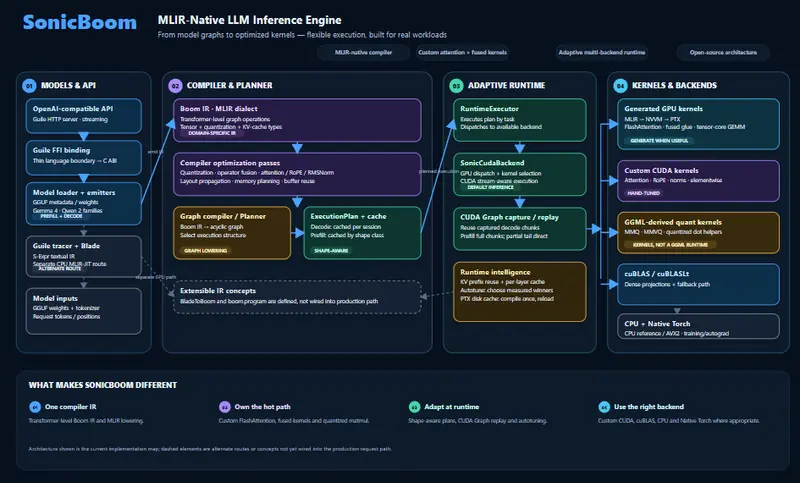
这种性能提升不仅源于底层内核,更得益于其独特的运行时架构。每个解码步骤都作为单个 CUDA Graph 重放运行,KV 缓存始终保留在设备端。其核心优势在于 llama.cpp 架构所缺乏的两个层级:一个图规划器和其后的 MLIR 编译器层。规划器通道融合了 norm、激活和量化操作,而 MLIR 层则直接生成 GPU 内核(包括融合胶水、注意力和 bf16 密集 GEMM)。此外,它的前缀缓存重用是精确的,延续计算与完全重计算 token 的结果完全一致。
SonicBoom 的定位是一个通用张量框架。开发者可以用 Scheme 编写模型,体验类似 PyTorch 的急切执行模式,随后这些模型会被追踪并编译成计算图。生产模型在 C++ 核心中定义,并可通过 C API 从任何语言提供服务。LLM 推理只是它的第一个基准测试,而非项目的最终限制。
所有性能数据均基于 3 次进程运行的中位数,在严格的基准条件下测得。两个运行时在同一会话中加载同一个 GGUF 文件进行对比。
测试环境:NVIDIA GeForce RTX 3050 (8 GB, sm_86), AMD Ryzen 5 5500, 32 GB DDR4 单通道内存, Ubuntu 24.04。对比基准锁定为特定的 llama.cpp 提交版本。
在 Gemma 4 E4B-it Q3_K_M 上:
在 Qwen2.5-0.5B-Instruct Q4_K_M 上:
需要注意的是,Qwen2 在 KV 深度 512 时的解码速度与 llama.cpp 基本持平(0.98×),这是因为 Qwen2 没有滑动窗口机制,所有 512 个键都会被关注,而 Gemma 的环形缓冲区会发生回绕。
SonicBoom 目前处于 v0.0.3 阶段,已在 CUDA sm_86 上对 Gemma 4 和 Qwen2.5 两个模型系列完成了端到端验证。
环境要求:Linux x86-64、g++-13、CMake、CUDA 工具包 12.0+(计算能力 6.1+,张量核心路径需 7.5+)以及 GNU Guile 3.0。
构建过程依赖 SonicCross,这是一个用 Guile 编写的代码生成工具,用于替代 PyTorch 的 torchgen,将 YAML 定义转换为 C++ 声明和分派源。SonicCross 仅在构建时运行,不会链接到最终的动态库中。
tools/mlir/build-mlir.sh 静态编译所需的 LLVM/MLIR 组件。cmake -S . -B build -DCMAKE_BUILD_TYPE=Release -DSONICBOOM_USE_CUDA=ON,随后执行 cmake --build build -j。运行示例(通过 Guile):
(use-modules (sonicboom inference))

(define model (load-model "models/gemma-4-E4B-it-Q3_K_M.gguf"))
(define session (make-session model 4096))

(display (generate model session "The three laws of thermodynamics are" 64))

;; 前缀重用是自动的:当同一会话上稍后的提示以相同 token 开始时,
;; 只有新后缀会被预填充。
(prefill! session (tokenize model "..."))

(free-session! session)
(free-model! model)
相同的函数也可通过 capi/include/sonicboom/capi.h 从 C 语言直接调用。对于希望在本地环境中追求极致推理性能、且愿意接受纯 C/C++ 技术栈的开发者而言,SonicBoom 提供了一个高度可控且性能优异的替代方案。