Molt
英伟达 NeMo 团队最新发布的 Molt是一个基于 PyTorch 原生的智能体强化学习框架,其核心设计目标极其明确:精简。据官方统计,Molt 的核心 RL 代码量仅为 8.6K 行,相比之下,流行的 Verl 框架约为 62K 行,Slime 为 25K 行。
 RRSI
Google Cloud AI Research 联合 UNC-Chapel Hill、Stanford 和 Washington University in St. Louis 发布 RRSI(Regularized Recursive Self-Improvement),一个 Apache 2.0 开源研究框架,使 LLM 智能体在模型权重冻结的前提下,自主重写其 harness(提示词、工具、记忆、控制流、子智能体)。
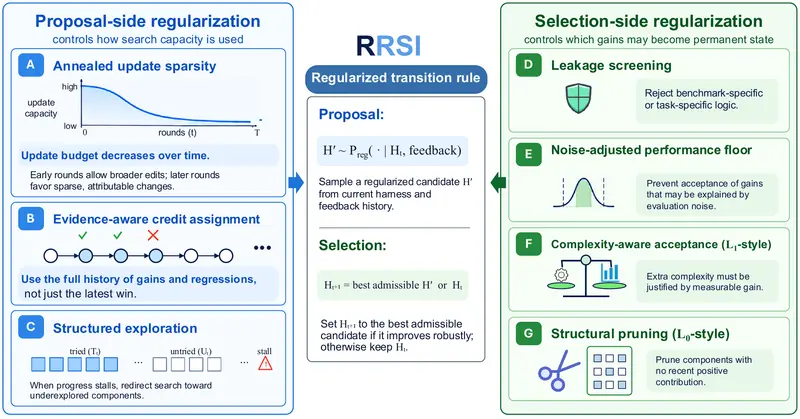
核心创新在于对改进循环本身施加正则化约束,防止 overfitting 到 evolve 集,确保增益迁移至从未参与优化的基准。使用 Claude Opus 4.8 时,Terminal-Bench 2.1 从 74.2% 提升至 80.2%,SWE-bench Verified(未用于选择)从 82.0% 升至 83.8%,6 个分布外基准全部提升;同时 harness token 消耗降低 30–36%。框架需 Python 3.10+,支持任意 LiteLLM 模型字符串,默认为 Vertex AI 上的 Claude Opus 4.8。明确标注为研究级代码,非 Google 官方产品。
传统 harness 演化循环在固定 evolve 集上评分并保留赢家,导致:
RRSI 通过正则化搜索过程本身来解决这些问题,而非限制可编辑组件。
| 机制 | 作用 | 经典正则化类比 |
|---|---|---|
| 退火编辑预算 | 早期捆绑多编辑探索,后期单编辑归因 | L0(稀疏性) |
| 证据感知信用 | 记录每个候选的组件/假设/diff/分数/成本变化;被证伪想法不再重试 | — |
| 结构化探索 | 停滞时转向未触碰组件,避免局部最优 | — |
| 机制 | 作用 | 经典正则化类比 |
|---|---|---|
| 泄漏批评者 | 评分前拒绝任务名/实体/答案/基准特定逻辑 | — |
| 噪声调整下限 | 增益必须超过基础 harness 方差 | — |
| 成本规则 | 额外 tokens 必须由实测增益支付 | Ridge (L2) |
| 修剪 | 停止产生增益的组件成为删除目标 | Lasso (L1) |
💡 关键设计:所有正则化作用于搜索过程,而非 harness 结构本身,保持组件完全可编辑。
| 基准 | 类型 | 基线 → RRSI | 备注 |
|---|---|---|---|
| Terminal-Bench 2.1 | Evolve | 74.2% → 80.2% | +6.0pp |
| SWE-bench Verified | 从未用于选择 | 82.0% → 83.8% | +1.8pp,证明迁移 |
| JobBench | OOD | — → +4.7 | 分布外 |
| GDPval | OOD | — → +3.5 | 分布外 |
| APEX-Agents | OOD | — → +3.7 | 分布外 |
| EngDesign | Evolve | — → +4.9 | Medal 分 |
| Frontier-Eng | Evolve | — → +4.3 | Medal 分 |
| Harvey LAB | Evolve / Holdout | +1.1 / +2.3 | 留出集提升更大 |
| 方法 | 核心思想 | 成本规则+修剪 | Harvey LAB (evolve) | OOD 平均 (H0=39.7) |
|---|---|---|---|---|
| RRSI | 正则化提议+选择 | ✅ | 90.5 | 43.6 |
| Meta-Harness | 轨迹感知提议者 | ❌ | 93.0 | 40.6 |
| AHE | 可观测性驱动 | ❌ | 90.7 | 39.2 |
| TTHE | 测试时无标签演化 | ❌ | 91.1 | 38.0 |
| HarnessX | 模块化类型原语 | ❌ | 91.8 | 39.7 |
📊 关键洞察:Meta-Harness 在 evolve 集领先,但 RRSI 是唯一 OOD 平均显著高于基线(+3.9) 的方法,证明正则化有效抑制 overfitting。
⚠️ 注意事项: