ContextGem
ContextGem 是一款强大且易用的文档分析工具,特别适合需要深度阅读和精准提取信息的场景。通过减少开发复杂度和提高自动化水平,它让用户能够专注于核心业务逻辑,而不是繁琐的技术细节。
腾讯全新开源框架 ContextPilot,借助强化学习赋予大模型自主规划、结构化记忆、软上下文卸载的能力,让 AI 学会主动整理自己的 “办公桌”,在更紧凑的上下文之内完成复杂长任务。
 ContextPilot
 是腾讯最新开源的一个强化学习框架,教会 AI Agent 主动规划、结构化记忆和软卸载上下文。针对长程任务中上下文无限膨胀的痛点,ContextPilot 让模型学会像人类整理办公桌一样,自主决定“何时记、何时忘、何时归档”,从而在大幅压缩实际 Token 用量的同时,显著提升长上下文问答与深度搜索的性能。
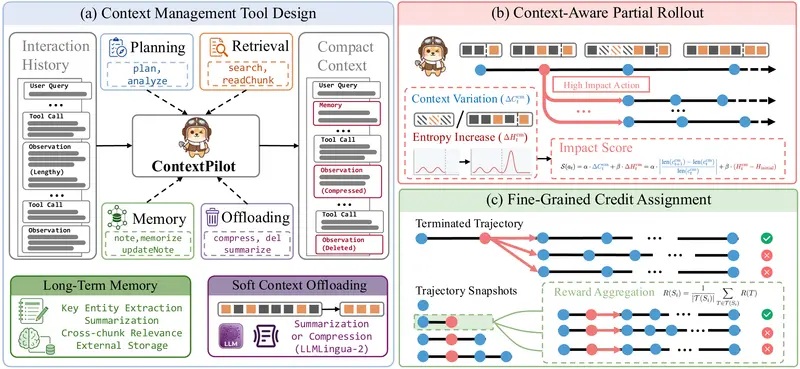
基于该框架训练的 Qwen3-14B 模型,仅凭 32K 上下文窗口便超越了原生 128K 窗口的基座模型,且实际使用的 Token 数量大幅减少。
ContextPilot 并非简单地截断或摘要,而是赋予模型一套完整的上下文管理工具链与决策能力:
除了常规的搜索/删除/摘要,新增了三大核心工具:
训练时不再对所有操作一视同仁。系统会智能判断哪些编辑动作对最终结果影响最大,仅对这些敏感的上下文编辑决策进行深度探索,其他普通操作则快速略过,极大提升了训练效率。
摒弃“只看最终成败”的粗犷奖励模式。系统会分析每一个中间编辑动作对后续分支的影响,给真正有用的整理动作“发奖金”,给拖后腿的动作“扣钱”。这让模型能精确学会哪些信息该留、哪些该扔、哪些该归档。
在长上下文 QA 和深度搜索任务上的实验表明,ContextPilot 实现了“更紧凑、更强悍”的双重突破:
| 指标 | 原生 128K 基座模型 | ContextPilot (Qwen3-14B) | 优势 |
|---|---|---|---|
| 有效上下文窗口 | 128K | 32K (等效超越 128K) | ✅ 4倍压缩比 |
| 实际 Token 消耗 | 高 | 大幅压缩 | ✅ 成本显著降低 |
| 长程任务性能 | 基准线 | 保持或提升 | ✅ 性能无损甚至更优 |
| 适用场景 | 通用 | 长程 Agent / 深度搜索 / 长文 QA | ✅ 专精复杂任务 |