SlideBot AI
SlideBot AI是一个基于真实企业需求打磨的智能演示文稿生成系统。只需输入主题、上传素材或会议录音,AI 即可自动生成结构清晰、设计专业的完整演示文稿,并支持全流程交互式调整。
CyVisGuard是一套开源、自包含的 AI Agent 安全控制平面。它坐在 agent——任何持有凭据、代表他人调用 工具的东西——与它能触及的一切之间,对每一次动作回答:谁在调用、代表谁、这是否还在它被 允许的范围内?
 CyVisGuard
当 AI Agent 开始代表你读取工单、查询数仓、调用内部 API 时,它就不再只是一个聊天机器人,而是一个持有凭据、能触碰生产系统的“数字员工”。
但问题也随之而来:如何确保它不会在提示词注入的诱导下泄露数据?如何防止它执行超出权限的操作?如何追踪它每一次动作的来龙去脉?
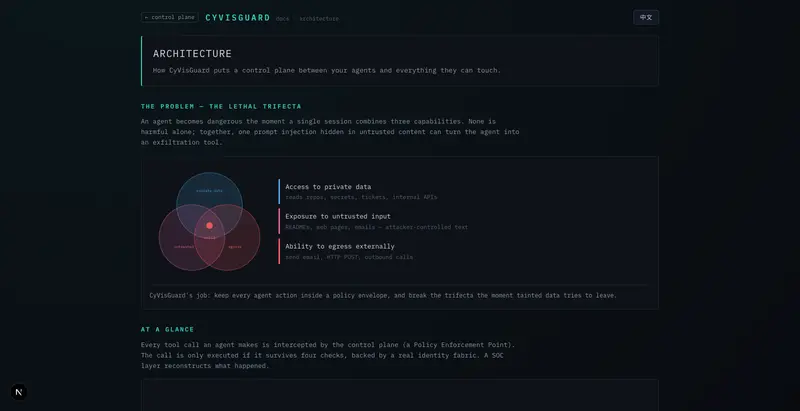
CyVisGuard 是一套开源、自包含的 AI Agent 安全控制平面。它 sits 在 Agent 与它能触及的一切资源之间,对每一次工具调用进行实时裁决:谁在调用?代表谁?这是否还在允许的范围内?
传统的模型层安全防护已经不够用了。真正的风险发生在动作层——身份与委托、能力策略、数据流污点,以及那条必须可回放的审计链。
CyVisGuard 将这些控制逻辑落在 MCP (Model Context Protocol) 上。这意味着,任何支持 MCP 协议的 Agent(如 Claude Code、Codex 等)都能无缝接入,获得统一的安全守护。
CyVisGuard 通过四个关键拦截点,构建了一道从网关到 Agent 内部的纵深防御体系:
| 层级 | 组件 | 守护对象 | 适用场景 |
|---|---|---|---|
| MCP 网关 | apps/mcp-gateway | 每一次工具调用:身份验证 → 策略检查 → 数据污点标记 → 审计记录 | 任意 MCP 客户端 |
| 聚合代理 | apps/mcp-proxy | 统一入口,为不同员工过滤出不同的工具视图,实现最小权限原则 | 组织级多用户管理 |
| 模型网关 | apps/model-gateway | 捕获工具层看不到的原始 LLM 请求与响应 | 走 Anthropic API 的 Agent |
| 深度挂钩 | apps/cc-hook | 针对 Claude Code 的原生工具(Read/Write/Bash 等)进行细粒度管控 | Claude Code 专属 |
其中,聚合 MCP 代理是多数企业最需要的形态。Agent 只连接 CyVisGuard,由它挡在下游 MCP Server 前面。员工看不到的业务工具根本不会出现在列表中,且通过令牌交换,下游服务看到的是真实的员工身份,而非代理本身。
在允许挂钩的场景下(如 Claude Code),CyVisGuard 甚至能守护 Agent 自身的攻击面:
cd 命令漂移。CLAUDE.md 或 Skill 文件,拒绝执行指纹不符的技能。CyVisGuard 的设计哲学非常务实:规则基线始终运行,模型判断只能增加怀疑,不能减少限制。
它提供了两个可替换的模型接缝:
你可以使用本地 Ollama 模型(如 Gemma4)来增强这些判断。即使模型缺席或被骗,底层的规则引擎依然能保证系统不会比没有模型时更弱。这种“单向合并”的逻辑,确保了安全性的底线。
CyVisGuard 提供了极简的演示流程,无需 API Key 或联网即可体验:
# 使用 Docker Compose 拉起看板并运行端到端测试
docker compose -f docker/compose.yml up --build
启动后,打开 http://localhost:4300/audit,你可以看到实时的审计流:一个模拟的 MCP 客户端尝试外泄数据被拦截,两名员工通过同一个网关看到了不同的工具视图。
如果没有 Docker,也可以在宿主机上通过 pnpm dev 和 pnpm --filter @cyvisguard/demo-flow start 运行。