Tab
Tab由三位开发者在今年初启动开发,使用方式非常简单:直接在iMessage或者WhatsApp给Tab发短信,下达任务指令。它拥有独立的手机号、浏览器环境与支付钱包,不是教你怎么做,而是直接代为执行。无论是采购杂货、挑选礼物、处理账单、代为拨打电话,都可以在聊天线程内完成。
 Strands Harness
AWS Strands Agents 团队发布 Strands Harness,一个完全组装的通用智能体 harness,以 Apache 2.0 许可提供 Python/TypeScript SDK。该框架将模型循环、工具调用、上下文管理、记忆与恢复等原语打包为可工作的默认配置,支持一行代码启动。
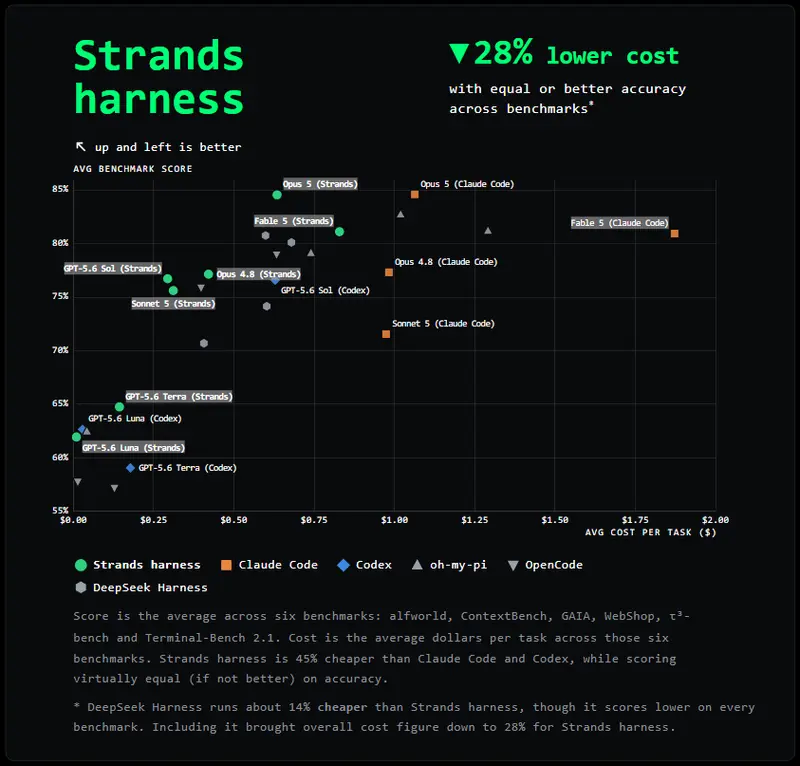
在 6 个基准(ALFWorld、ContextBench、GAIA、WebShop、τ²-bench、Terminal-Bench 2.1)上使用相同 Claude/GPT 模型测试,Strands Harness 相比其他主流 harness 平均 token 成本低 28%,准确率相当。在 Terminal-Bench 2.1 的 Claude Fable 5 头对头测试中,其成本比 Claude Code 低 77%,准确率高 7.9 分。
Strands Harness 的成本优势主要源于三条内置上下文管理规则:
这些默认值经实证验证有效。独立研究 HarnessTax 已证实:harness 选择对成功率影响微弱,但同一模型在不同 harness 下成本差异可达 5 倍。Strands 的后续论文将进一步量化其上下文策略的贡献。
| Harness | 运行成本 | 准确率 | 成本 vs Strands |
|---|---|---|---|
| Strands Harness | $56.29 | 69.7% | 基准 |
| Oh-my-pi | $86.83 | 69.7% | +54% |
| OpenCode | $73.42 | 66.3% | +30% |
| Claude Code | $248.05 | 61.8% | +341% |
| DeepSeek Harness | $40.30 | 59.5% | -28% (但准确率低 10.2 分) |
⚠️ 注意:DeepSeek Harness 虽成本最低,但准确率显著落后;将其纳入使整体节省数字从更高值降至 28%。Strands 在成本-准确率帕累托前沿上占据最优位置。
create_harness() 返回的智能体默认具备:
strands-cli 支持自然语言描述 → /export 生成含 MCP 服务器的完整 harness 代码(Python/TS zip)# Python
pip install strands-harness
# TypeScript
npm install @strands-agents/harness
from strands_harness import create_harness

agent = create_harness(model="litellm/openai/gpt-5.6-sol")
agent("Research the top three vector databases and compare their pricing")