BarraCUDA
BarraCUDA是一个面向 AMD GPU 的开源 CUDA 编译器,并计划支持更多架构。用 15000 行 C99 代码编写。零 LLVM 依赖。直接将 .cu 文件编译为 GFX11 机器码,并生成 AMD GPU 可以实际运行的 ELF .hsaco 二进制文件。
Standup Pulse 是一个本地优先的 Slack 异步站会代理,带有 Angular 管理仪表板。它通过 llama.cpp 运行一个优化的 Unsloth Gemma 4 26B A4B MoE GGUF,带有 MTP 推测解码,使用 Mastra 作为代理,CopilotKit Channels 作为 Slack 传输,以及 ...
 Standup Pulse
 是一个注重隐私和本地控制的 Slack 异步站会(Daily Standup)解决方案。它利用本地运行的大语言模型处理团队每日更新,并通过一个功能丰富的 Angular 管理仪表板展示团队状态。
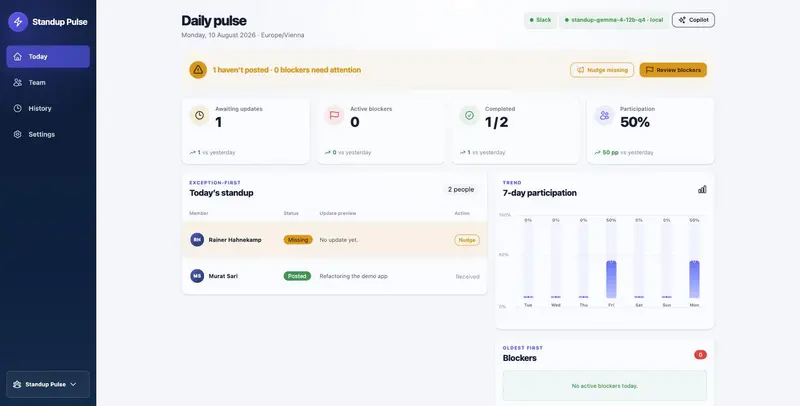
该项目展示了如何将高性能本地模型、现代 Web 框架和 AI 代理框架结合,构建出一个完全自托管、数据不出本地的企业级应用。
Standup Pulse 采用了一套前沿且高度模块化的技术组合:
unsloth/gemma-4-26B-A4B-it-GGUF (Q4_K_M 量化),基于 Gemma 4 架构的混合专家 (MoE) 模型。llama.cpp,启用 MTP (Multi-Token Prediction) 推测解码以加速生成。@standup-pulse 被提及时响应,避免干扰无关频道对话。http://localhost:4111),开发者可以实时查看代理的思维链、工具调用、输入输出及耗时。pnpm install
在一个终端窗口中运行:
tools/model/start-local-model.sh q4
这将加载 Gemma 4 26B 模型并启动 llama.cpp 服务器。
在另一个终端窗口中运行:
pnpm nx serve dashboard
http://localhost:4200http://127.0.0.1:3000/api/status 可查看模型、代理、数据库和 Channel 的健康状态。用于调试代理行为:
pnpm nx run api:studio
访问 http://localhost:4111,选择 “Standup Pulse” 预设即可开始调试。
Standup Pulse 使用 CopilotKit Channels 进行 Slack 集成。配置位于 .copilotkit/channels.json:
standup-pulse#standup-bot-testing检查状态:
npx --yes copilotkit@4.8.1 channels status --json
安全注意:
.env 文件中,该文件已被 git 忽略。Standup Pulse 采用了清晰的职责分离架构来处理 Slack 交互:
standup-channel-domain.ts):定义模型可调用的最小化工具接口(如提交站会、渲染图表)。channel-handlers.ts):处理提及事件、订阅逻辑和错误恢复。standup-tools.tsx):实现具体的业务逻辑,如解析站会文本、生成团队脉搏图。channel-runtime.ts):管理 Channel 的生命周期和 Intelligence 配置。这种设计确保了核心业务逻辑与特定平台(Slack)的解耦,未来可以轻松扩展到其他通讯平台(如 Teams 或 Discord)。