rnskill
rnskill 是由开发者“雪踏乌云”维护的一套 comprehensive AI Agent Skill 集合,专为 Codex、Claude Code 及其他支持 SKILL.md 标准的工作流设计。目前包含 54 个技能,覆盖从选题策划、脚本洗稿、视频制作到商业诊断的全链路内容创作,以及通用的编码开发辅助。
 anydoc
 是由 Firecrawl 开发的开源 Rust 库,专为将办公文档(Word、PowerPoint、Excel、OpenDocument、RTF、EPUB、CSV、PDF)转换为干净的 GitHub-Flavored Markdown 而设计。其核心优势在于个位数毫秒级转换速度、统一输出结构及零外部依赖。提供 Node.js、Python、浏览器 WebAssembly 及原生 Rust 四种绑定,所有接口共享同一文档模型与序列化器,确保跨格式行为一致。内置基于内容的格式检测,无需依赖文件扩展名;嵌入资产保留原始字节并标记媒体类型;Node.js/Python 绑定均不阻塞主线程/GIL。可作为 Agent Skill 一键集成至 Claude Code、Codex 等智能体环境,或通过托管 API(Firecrawl Parse)获得 OCR 增强能力。
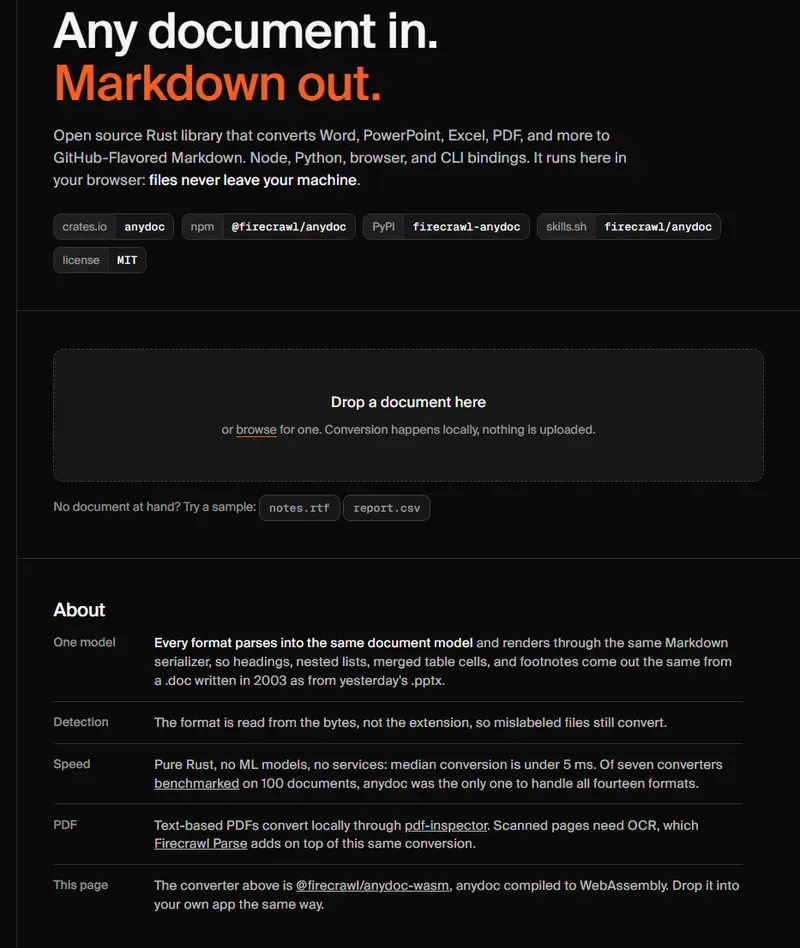
anydoc 的设计哲学是“解析归一化,渲染标准化”,避免为每种格式维护独立输出逻辑:
.doc 与 .pptx 的表格转义、链接处理、代码块渲染等行为完全一致%PDF-、RTF {\rtf、OLE 流名、ZIP mimetype)自动判定格式,标签错误的文件仍可正确转换。CSV 等无签名格式需显式指定这种架构使 anydoc 成为 RAG 管道、知识库构建、文档迁移等场景的理想预处理层——下游 LLM 接收的是结构稳定、语义完整的 Markdown,而非格式碎片。
CLI 快速验证
npx @firecrawl/anydoc report.docx               # stdout 输出
npx @firecrawl/anydoc slides.pptx -o out.md     # 写入文件
npx @firecrawl/anydoc - --format csv < data.csv # stdin 输入
首次运行自动下载预编译二进制;全局安装用 npm install -g @firecrawl/anydoc。
编程接口要点
| 语言 | 安装命令 | 关键函数 | 注意事项 |
|---|---|---|---|
| Node.js | npm install @firecrawl/anydoc | toMarkdown(path) / toMarkdownBytes(buf, fmt?) | CSV 必须传 fmt 参数 |
| Python | pip install firecrawl-anydoc | to_markdown(path) / to_markdown_bytes(data, fmt?) | 同上 |
| WASM | npm install @firecrawl/anydoc-wasm | await init() + toMarkdownBytes(buf, fmt?) | 浏览器端仅支持字节输入 |
| Rust | cargo add anydoc | to_markdown(path)? / to_document(bytes, fmt?)? | 返回 Result,需错误处理 |
Agent Skill 集成
npx skills add firecrawl/anydoc
执行后,Claude Code/Codex/Cursor/OpenCode 等兼容代理即获得文档读取能力。Skill 封装了 CLI 调用逻辑,代理可直接理解“请分析这份合同”等自然语言指令并自动触发转换。
高级用法:文档模型访问
当需要提取嵌入图片或结构化元数据时,使用 toDocument() 获取完整文档对象,而非直接转 Markdown。该对象包含所有资产字节、媒体类型及语义节点,便于自定义后处理。
尽管 anydoc 覆盖主流办公格式,仍需注意以下限制:
.docm/.xlsm 等启用宏的文件仅提取内容,VBA 代码被忽略以防止安全风险何时选择 anydoc vs 替代方案
对于大多数 AI 应用场景,anydoc 提供了当前最优的“文档理解前置层”——它不做智能解读,只做精准转译,把复杂性留给下游模型,把确定性留给工程系统。这种克制恰恰是其价值所在。