Uno Platform
Uno Platform 是一个全面的开源平台,提供一套企业级工具,旨在帮助开发者以高效、高生产力的方式构建跨平台.NET 应用程序 。该平台的核心价值在于通过允许单一代码库在多个平台上运行,显著提升开发者的生产力,从而快速高效地构建任务关键型.NET 应用程序 。
agent-vision-toolkit 是一套专为纯文本大语言模型(如 DeepSeek V4)设计的视觉能力增强工具包。它通过提供一系列结构化的 CLI 工具和 Skill 指导,让不具备原生多模态能力的 Agent 也能高效完成图片问答、长图 OCR、UI 还原、GUI 自动化等复杂视觉任务。
 agent-vision-toolkit
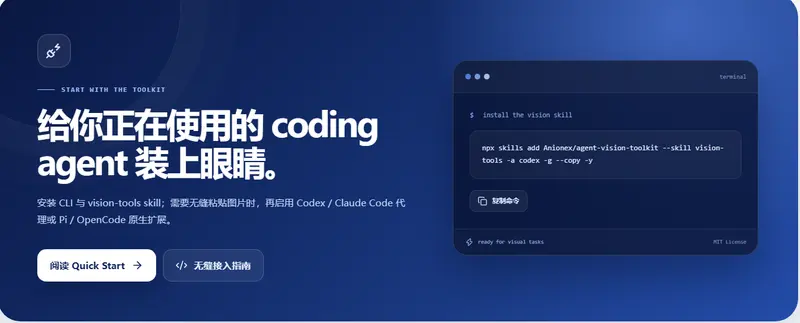
 是一套专为纯文本大语言模型(如 DeepSeek V4)设计的视觉能力增强工具包。它通过提供一系列结构化的 CLI 工具和 Skill 指导,让不具备原生多模态能力的 Agent 也能高效完成图片问答、长图 OCR、UI 还原、GUI 自动化等复杂视觉任务。此外,它还提供了可选的无缝接入层,支持在 Codex、Claude Code、Pi 等主流 Agent 框架中直接粘贴图片并使用内置看图工具。
与传统“截图转通用描述”的方案不同,该工具包强调意图驱动(Intent-Driven)。它会从用户消息或模型自述中提取看图的动机(Focus Hint),并将其传递给后端的多模态视觉 API。这使得返回的描述不再是宽泛的图像总结,而是紧扣当前任务关键细节的结构化信息,从而显著降低语义损耗,提升准确率与响应速度。
| 用例场景 | 实现方式 |
|---|---|
| 长截图/聊天记录识别 | 避开文字寻找安全切口,逐块 OCR 并保留发言人、时间及引用关系,自动合并重复内容。 |
| UI 还原与设计稿对齐 | 结合原生 UI 代码、截图素材与视觉对比,逐轮对齐页面组件,优先复用项目已有资产。 |
| 图形素材提取与重建 | 从原图提取透明 PNG,或在需要无损缩放时重建 SVG,并验证形状、颜色及边缘。 |
| 草图/白板转结构化代码 | 识别节点、连线与方向,输出可编辑的 Mermaid 或 Graphviz 代码。 |
| GUI 自动化操作 | 定位控件 -> 执行操作 -> 重新截图验证,避免在过期截图上连续操作导致的错误。 |
dsh-vision-toolkit 子包,作为原生 Profile Bundle 接入,提供 10 个结构化视觉工具。将以下指令发送给您的 Agent:
“根据 https://github.com/Anionex/agent-vision-toolkit 的仓库指引,在本地安装视觉工具箱和 skill。如果视觉 API 尚未配置,请按当前系统找到配置文件,并引导我填写 VISION_API_KEY、VISION_BASE_URL 和 VISION_MODEL。”
若希望支持直接粘贴图片和使用内置看图工具,请发送:
“完整阅读 https://github.com/Anionex/agent-vision-toolkit/blob/main/AGENT_INSTALL.md,根据我们当前使用的 agent 应用,安装适用的视觉代理或原生 extension/plugin。如果视觉 API 尚未配置,请按当前系统找到配置文件,并引导我填写 VISION_API_KEY、VISION_BASE_URL 和 VISION_MODEL。”
VISION_API_KEY、VISION_BASE_URL 和 VISION_MODEL。