LangExtract
LangExtract 不是一个通用的文本分析工具,而是专注于“从非结构化文本中提取结构化信息”的垂直解决方案。它将大语言模型的强大理解力与工程化设计结合,强调准确性、可追溯性和实用性,为专业领域的文本处理提供了新的可能性。
MemHarness 是一个框架,它使 LLM 代理能够根据当前上下文主动利用和重构过往经验——而非逐字回放检索到的记忆。MemHarness 将记忆引导的决策分解为五个阶段——观察 → 检索 → 批判 → 重构 → 行动。
 MemHarness
在构建智能体(Agent)时,我们常以为“记忆越多越好”。但现实往往相反:当旧经验与当前状态不匹配时,强行套用反而会导致决策失误,这种现象被称为负迁移。
上海 AI 实验室最新开源的 MemHarness 框架,它不追求记忆容量的无限扩张,而是教会 Agent 像人一样“看情况改答案”,在检索与行动之间插入了关键的“批判”与“重构”环节。
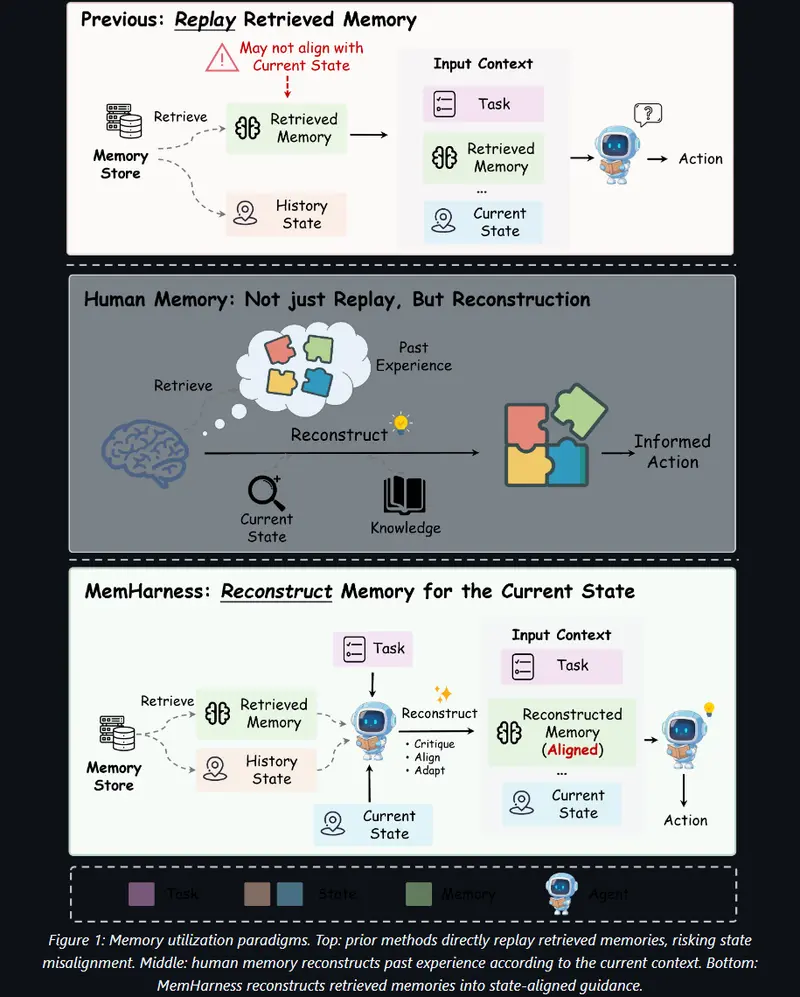
大多数记忆增强型 Agent 将检索到的经验视为静态记录,直接注入上下文。这种“回放”范式忽视了历史经验的抽象性与当前情境的具体性之间的差距。
MemHarness 受人类记忆重构机制启发,将决策流程重塑为五个阶段:观察 → 检索 → 批判 → 重构 → 行动。
最关键的是,这种重构能力无需任何人工标注,完全通过 GRPO(Group Relative Policy Optimization)结合任务奖励端到端训练自然涌现。这意味着迁移成本极低,换到新任务或新领域时,只需让 Agent 自主运行即可适应。
尽管仅有 7B 参数量,MemHarness 在多个基准测试中展现了惊人的性能:
| 基准测试 | MemHarness 成功率 | 对比纯 GRPO 提升 | 对比 Gemini-2.5-Pro 提升 |
|---|---|---|---|
| ALFWorld | 85.2% | +8.8% | +23.1% |
| WebShop | 75.6% | +9.5% | +39.7% |
MemHarness 维护一个显式、可检查的记忆库,同时将状态条件化的重构参数化到单一策略模型中: