GetCheapAI
GetCheapAI 是一个专注、高效的 AI 模型价格信息平台,旨在通过透明的数据对比,帮助开发者快速找到最适合自己业务需求且最具性价比的模型服务。
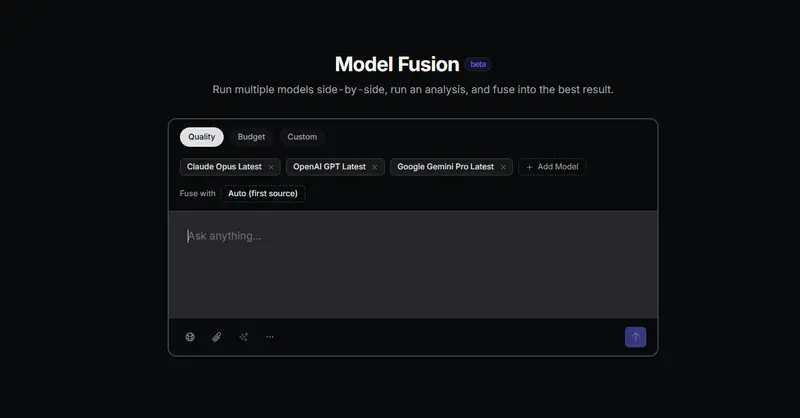
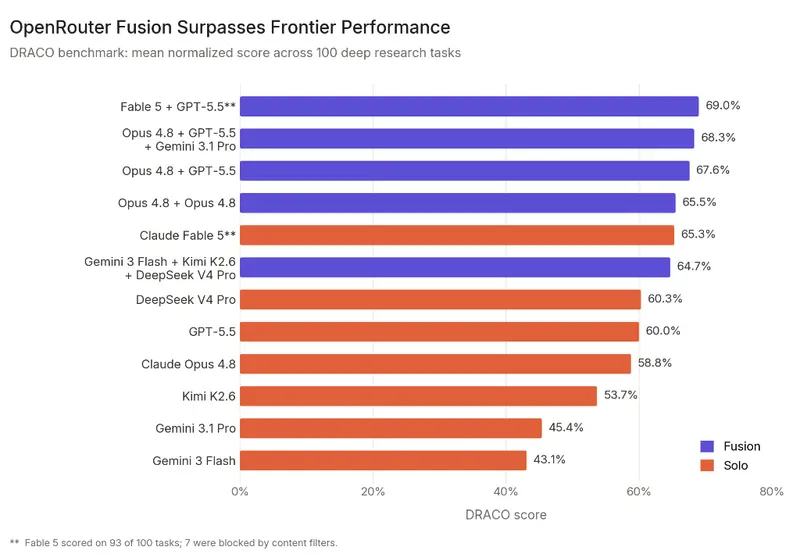
OpenRouter 正式推出了API 工具 Fusion,它通过并行分发与智能综合机制,将多个模型的输出融合为单一、更高质量的答案。测试显示,Fusion 不仅在 DRACO 深度研究基准中取得了 69.0% 的历史最高分,更证明了“模型多样性”带来的群体智能优势——甚至三个平价模型的组合也能以一半的成本击败顶级旗舰模型。
 OpenRouter Fusion
在追求大模型极致性能的道路上,单一模型的瓶颈日益显现。OpenRouter 正式推出了API 工具 Fusion,它通过并行分发与智能综合机制,将多个模型的输出融合为单一、更高质量的答案。测试显示,Fusion 不仅在 DRACO 深度研究基准中取得了 69.0% 的历史最高分,更证明了“模型多样性”带来的群体智能优势——甚至三个平价模型的组合也能以一半的成本击败顶级旗舰模型。
excluded_domains / blocked_domains),确保测试结果的真实性与可靠性。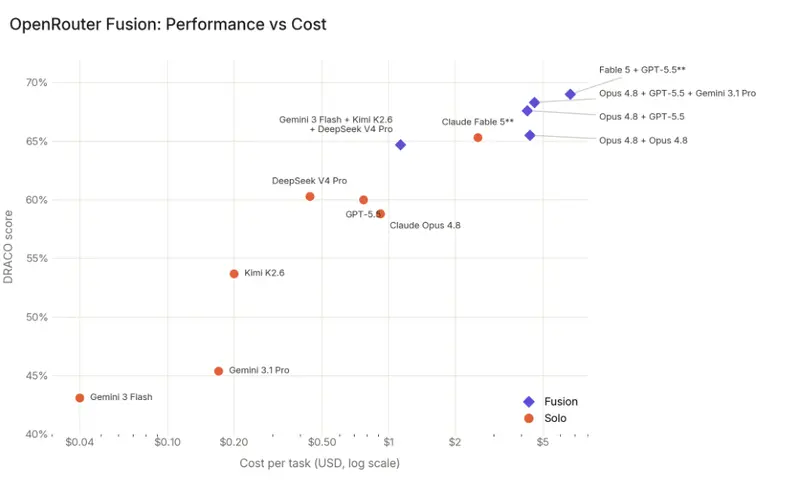
| 类型 | 模型组合 / 单模型 | DRACO 得分 | 备注 |
|---|---|---|---|
| Fusion | Fable 5 + GPT-5.5 (裁判: Opus 4.8) | 69.0% | 全场最佳 |
| Fusion | Opus 4.8 + GPT-5.5 + Gemini 3.1 Pro | 68.3% | 三模型融合 |
| Fusion | Opus 4.8 + GPT-5.5 | 67.6% | 双旗舰融合 |
| Fusion | Opus 4.8 + Opus 4.8 (裁判: Opus 4.8) | 65.5% | 自融合增益显著 |
| Solo | Claude Fable 5 | 65.3% | 单模型最高 (注: 7/100 任务因过滤器未完成) |
| Fusion | Gemini 3 Flash + Kimi K2.6 + DeepSeek V4 Pro | 64.7% | 平价组合,性价比之王 |
| Solo | DeepSeek V4 Pro | 60.3% | – |
| Solo | GPT-5.5 | 60.0% | – |
| Solo | Claude Opus 4.8 | 58.8% | – |
(注:DRACO 基准包含 100 个深度研究任务,涵盖学术、金融、法律等 10 个领域,重点评估事实准确性、广度深度及引用质量)
"model": "openrouter/fusion" 即可像调用普通模型一样使用。API 调用示例:
{
  "model": "openrouter/fusion",
  "messages": [
    { "role": "user", "content": "支持碳税的最有力论点和反对碳税的最有力论点是什么?" }
  ]
}
自定义组合示例:
{
  "model": "openrouter/fusion",
  "plugins": [{
    "id": "fusion",
    "model": "google/gemini-3-flash-preview", // 裁判模型
    "analysis_models": [
      "google/gemini-3-flash-preview",
      "moonshotai/kimi-k2.6",
      "deepseek/deepseek-v4-pro"
    ]
  }]
}