ARmahjongAssist (AR麻将助手)
ARmahjongAssist 是一个结合 RayNeo AR 眼镜 与 本地化 AI 的麻将辅助系统。通过 AR 眼镜实时采集手牌图像,在本地服务器进行 YOLO 识别与牌效分析,并将最佳切牌建议实时投射在眼镜屏幕上。
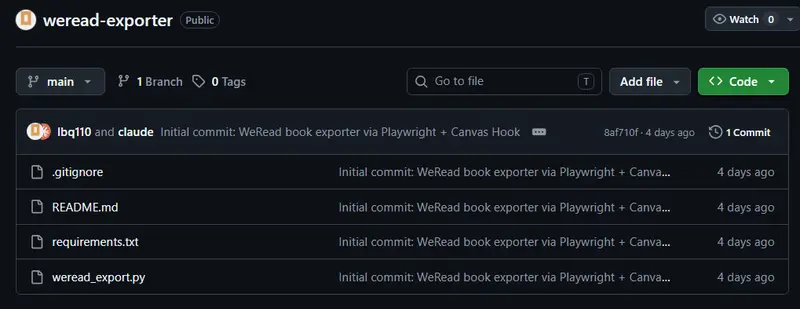
weread-exporter是一款微信读书全本导出工具 — 通过 Playwright + Canvas Hook 提取完整书籍内容,导出为 Markdown。
 weread-exporter
微信读书网页版为了防抓取,采用 Canvas 而非 DOM 节点渲染文字,导致传统复制粘贴失效。weread-exporter 是一款专为解决此难题设计的开源工具。它通过 Playwright 自动化浏览器,结合创新的 Canvas fillText Hook 技术,拦截底层绘图指令,将像素级的字符坐标重新重组为可读、可搜索、可编辑的 Markdown 文档,助你轻松构建个人数字图书馆。
CanvasRenderingContext2D.fillText() 调用,捕获每一个字符及其精确的 (x, y) 坐标。cache/browser_profile/。meta.json,包含书名、作者、章节列表等。pip install playwright
playwright install chromium
基础导出:
# 传入书籍 URL
python weread_export.py https://weread.qq.com/web/bookDetail/dd6324f0813ab9f97g019a24

# 或直接传 book_id
python weread_export.py dd6324f0813ab9f97g019a24
高级选项:
# 指定输出目录
python weread_export.py <book_id> -o ./my_library

# 不保存原始 Canvas 数据(节省空间)
python weread_export.py <book_id> --no-raw
fillText 数据。