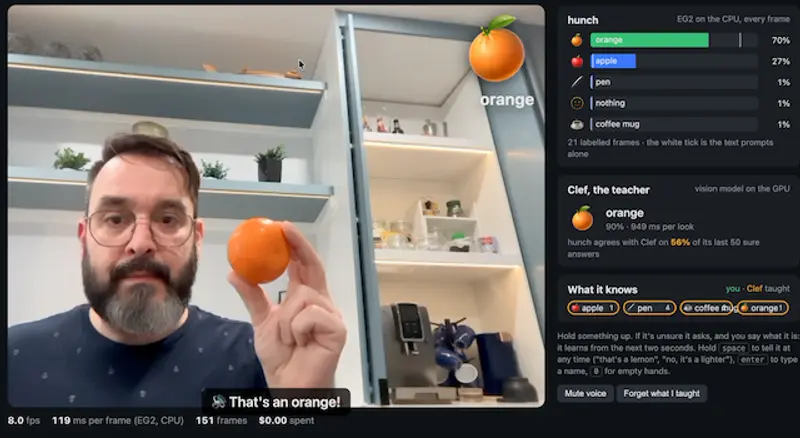
hunch 是一款基于 EmbeddingGemma 2 与 Rust 优化引擎、专为高容量、低延迟场景设计的“System One”风格快速决策服务器。它通过创新的“教师-学生”蒸馏机制,能够在普通 CPU 上以毫秒级延迟完成对文本或图像的实时分类与判断,大幅降低了传统 LLM 评判器(LLM-as-a-judge)在规模化应用中的成本与延迟。
核心机制与工作原理
hunch 的核心在于其动态的学习与接管机制,专为处理重复性高、模式固定的决策问题而设计:
- 教师-学生蒸馏:初始阶段,hunch(学生分类器)会调用更强大但昂贵的“教师”模型(如前沿 LLM 或专用决策模型)来获取答案,并基于 EmbeddingGemma 2 生成的语义状态嵌入进行学习。
- 毕业与审计 (Graduation & Auditing):当 hunch 的预测与教师模型的答案达到足够高的一致性时,它会“毕业”并开始独立、快速地回答问题。即使在毕业后,系统仍会定期将部分请求发送给教师进行“审计”,以确保持续的准确性。
- 安全回退机制:如果 hunch 遇到置信度低或超出其学习分布的复杂问题,它会自动将请求回退给教师模型,而不是强行给出错误答案,从而保证了系统的可靠性。
核心特性与技术亮点
- 极致性能与无 GPU 依赖:底层引擎
eg2cpu 基于高度优化的 Rust 实现,专为 Google 的 EmbeddingGemma 2 模型定制。它完全在商品级 CPU(支持 AMX 指令集)上运行,无需昂贵的 GPU 资源。 - 毫秒级延迟:在 Apple M5 Pro 上,处理约 190 token 的工具调用结果,文本决策的 P50 延迟仅为 22 毫秒;在 24 核 Sapphire Rapids 服务器上,批处理模式下每文本编码仅需约 0.6 毫秒。
- 结构化决策支持:专为固定答案类型的问题设计,包括二分类(是/否)、多选(choice)或有序评分(score),非常适合规则明确的自动化校验。
- 动态生态集成:配套的
hunch.live 库(支持 Python 和 TypeScript)允许开发者在文本和图像上实时构建动态选择式问题,并持续从教师模型和用户反馈中在线学习。
典型应用场景与边界
- 智能体轨迹实时分析:在 AI Agent 循环中,实时检查数百行代码、工具调用或日志是否存在失败模式、提示注入(Prompt Injection)或 PII(个人身份信息)泄露。
- 高吞吐内容审核:对用户评论、转录稿或系统日志进行快速的分类与打标。
- 能力边界:hunch 擅长“快速直觉”式的模式识别,不适用于需要大量间接推理或深度因果分析的复杂问题(例如:“这个失败有多严重,谁能修复它?”)。官方提供了预检指南,帮助开发者评估哪些问题适合交由 hunch 接管。
部署与开发
项目采用 Rust 与 Python/TypeScript 混合架构,依赖 uv 和 maturin 进行构建。开发者可通过官方提供的示例(涵盖编码智能体轨迹、InjecAgent、SST-5 等公共数据集)快速进行离线测试与性能基准验证。