CyberVerse
CyberVerse 是开源的数字人智能体平台,支持实时视频通话。你可以创建一个能看、能听、能面对面交流的 AI 智能体,体验与真实视频通话无异。
OpenTalking 是一个开源实时数字人框架,目标是把 数字人对话产品 需要的链路串起来:前端交互、会话状态、LLM 回复、TTS/音色选择、打断控制、字幕事件、WebRTC 音视频播放,以及外部模型服务调用。
 OpenTalking
构建一个低延迟、高保真的实时数字人应用,通常意味着要处理复杂的 LLM 集成、流式 TTS、唇形同步模型以及 WebRTC 信令交互。OpenTalking 是一个面向实时对话的开源数字人产线编排层,旨在通过模块化设计,让你只需关注业务逻辑,而将底层复杂性交给框架。
无论是想快速验证 API 连通性,还是希望部署企业级的高保真数字人,OpenTalking 都提供了从“轻量 Demo”到“高质量生产”的完整路径。
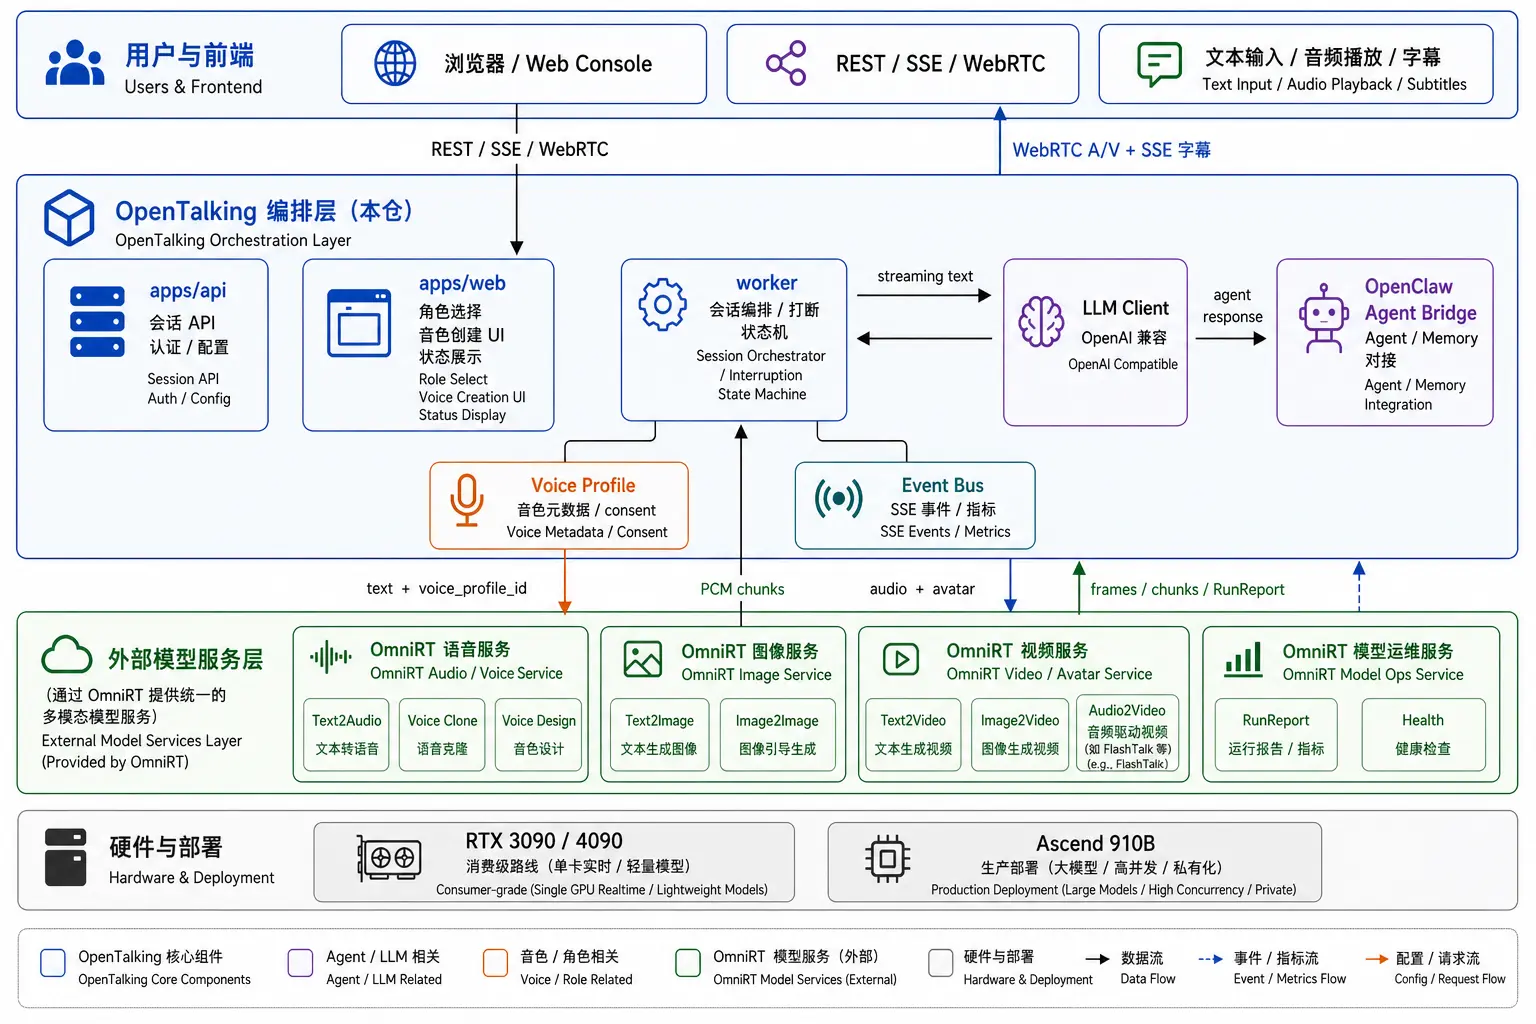
OpenTalking 设计了三种使用模式,满足不同阶段的需求:
demo-avatar + Wav2Lip,无需下载大模型权重,无需独立推理服务。适合首次验证 API、TTS 和 WebRTC 链路。MuseTalk 等轻量模型,用于验证 Avatar 资产格式和模型适配器,平衡速度与效果。确保已安装 Python ≥ 3.9, Node.js ≥ 18, FFmpeg。
git clone https://github.com/datascale-ai/opentalking.git
cd opentalking

python3 -m venv .venv
source .venv/bin/activate
pip install -e ".[dev]"

cp .env.example .env
在 .env 文件中填写必要的 API Key(以阿里云百炼为例,也可替换为其他提供商):
# 快速体验模式:关闭 FlashTalk,使用轻量 Wav2Lip
OPENTALKING_DEFAULT_MODEL=wav2lip
OPENTALKING_FLASHTALK_MODE=off

# LLM 配置 (示例:阿里云百炼 Qwen)
OPENTALKING_LLM_BASE_URL=https://dashscope.aliyun.com/compatible-mode/v1
OPENTALKING_LLM_API_KEY=sk-your-dashscope-key
OPENTALKING_LLM_MODEL=qwen-flash

# STT 配置
DASHSCOPE_API_KEY=sk-your-dashscope-key
OPENTALKING_STT_MODEL=paraformer-realtime-v2

# TTS 配置 (默认 Edge TTS,免费且无需 Key)
OPENTALKING_TTS_PROVIDER=edge
OPENTALKING_TTS_VOICE=zh-CN-XiaoxiaoNeural
打开两个终端窗口:
终端 1:启动后端
cd opentalking
source .venv/bin/activate
bash scripts/start_unified.sh
终端 2:启动前端
cd opentalking/apps/web
npm ci
npm run dev -- --host 0.0.0.0
浏览器访问 http://localhost:5173,即可开始与你的数字人对话!
| 模型类型 | 名称 | 特点 | 适用场景 |
|---|---|---|---|
| 轻量口型同步 | wav2lip (默认) | 无需独立服务,计算量小 | 快速验证、低保真 Demo |
| 进阶口型同步 | musetalk | 效果优于 Wav2Lip,仍需本地推理 | 资产适配验证、中等质量需求 |
| 高保真渲染 | soulx-flashtalk-14b | 需 OmniRT + FlashTalk WebSocket | 生产级部署、高拟真度需求 |
| 轻量化高清 | soulx-flashhead-1.3b | 较小参数量,HTTP 接口 | 资源受限环境下的高质量尝试 |
💡 提示:若要启用高质量 FlashTalk 模式,需参考
.env.flashtalk.example配置 OmniRT 服务地址,并启动相应的推理后端。