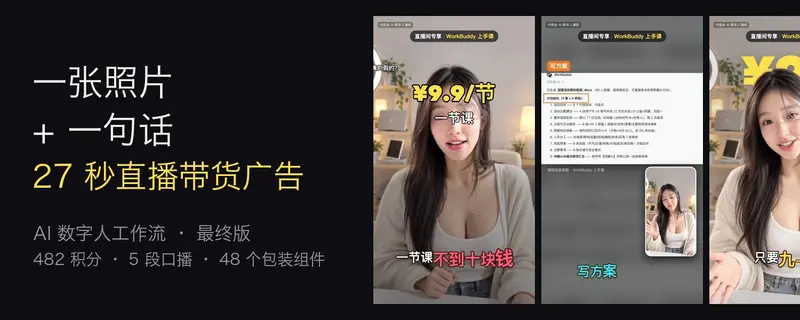
Digital Human Koubo 是一款基于 AI Agent 的自动化数字人口播视频生成工作流。它通过整合文本生成、图像/视频生成、语音处理与自动化剪辑技术,实现了“一张照片 + 一段文本”即可产出具备头部博主级包装的口播成片。

核心特性与技术亮点
该工具在设计上高度关注成片质量、成本控制与流程自动化,具备以下核心能力:
- 固定数字人设定:通过
persona.json 固化数字人的面部、服装、声音描述与提示词模板,确保多期视频中人物形象的一致性。支持结合 GPT Image 合成特定场景(如直播间、门店)的开场画面。 - 精准对口型与多模型支持:文稿被切分为 ≤15 秒的片段,默认通过 Renoise MCP 调用 Grok Video 1.5 生成对口型视频。同时也提供了 Wan 3.0 或 OmniHuman(支持自定义录音驱动口型)的适配方案。
- 严格的质量控制与成本控制:
- 先报价后生成:Agent 在生成前会预估段数、秒数、积分与余额,并支持先试拍第 1 段,用户确认后再批量生成。
- 双重质检机制:使用 Whisper 进行语音回听并与原稿比对;同时抽取 4 帧进行视觉检查,防止视频模型意外在画面中“烧录”字幕。
- 专业级音频与视觉包装:
- 声音统一:通过 1/3 倍频程频谱匹配、去齿音、统一小房间混响与响度(-14 / -16 LUFS),使分段生成的口播听起来如同一次性录制完成。
- 头部博主级包装:内置 48 个包装组件(拆解自 MrBeast、影视飓风、何同学等 25 支头部博主视频),Agent 会根据内容诊断并推荐剪辑风格。
- 景深字与智能封面:利用 macOS Vision 人像分割实现文字位于人物后方的“景深字”效果;自动生成多比例(16:9 / 9:16 / 3:4)封面,并将其拼接为成片首帧(停留 0.5 秒),适配各平台默认抓取首帧作为封面的机制。
- 多语言支持:实测支持英、日、韩、法、西、阿拉伯语,Whisper 回听准确率达 94%–100%。
标准化自动化工作流
整个生成过程由 Agent 自动编排,包含 9 个标准步骤:
- 环境检查:验证 Renoise MCP、ffmpeg、whisper 等依赖是否就绪。
- 内容诊断:从 5 种预设风格中推荐 2 种,生成
brief.json。 - 文稿拆分:生成
script.json,控制每段时长 ≤15 秒(中文约 5.4 字/秒)。 - 报价与试拍:用户确认预算后,先生成第 1 段供审核,随后批量执行。
- 下载与质检:分片下载防 CDN 截断,执行 Whisper 回听与抽帧检查。
- 音频后期:执行频谱匹配、去齿音与混响统一。
- 时间轴生成:输出逐字对齐的
tl.json。 - Remotion 剪辑:应用风格模板、默认包装及用户指定的特殊手法进行渲染。
- 封面合成:挑选最佳主播帧,添加钩子大字与证据卡,拼接至视频开头。
Agent 兼容性与部署要求
该工具以标准 SKILL.md 格式发布,包含 Python/Shell/Remotion 脚本。要完整运行该工作流,Agent 需具备三项核心能力:安装 Agent Skills、连接远程 MCP 服务器、在本地执行命令行工具。
- 已验证支持的 Agent:Claude Code(本项目开发环境)、Codex。
- 预期/应可用的 Agent:OpenClaw、WorkBuddy、以及支持自定义 MCP 和本地命令执行的豆包、千问办公、纳米 Work 等产品。
- 本地环境依赖:需安装 ffmpeg、Python 3(含 numpy、Pillow、Playwright)、Node.js 18+(用于 Remotion)以及 whisper.cpp。项目提供了
doctor.sh 脚本用于一键检查环境完整性。
进阶配置:自定义数字人与专属音色
- 打造专属数字人:用户提供一张正脸、光线均匀、闭嘴的授权照片。Agent 会调用 GPT Image 2.5 生成四视图(约 23 积分)以保证多角度一致性,随后通过 Grok Video 1.5 与 Wan 3.0 进行 8 秒对比测试,最终将选定的参考图上传至 Renoise 并写入
persona.json。 - 可选 TTS 集成:默认使用 Grok 生成的声音以保证口型最准。若需克隆专属音色或进行纯旁白制作,可配置小米 MiMo TTS API。需注意,事后替换音频会导致约 100 毫秒的口型偏差,若追求极致口型同步,建议直接使用支持“音频驱动口型”的模型(如 OmniHuman)。
 Digital Human Koubo · AI 数字人口播