Nova Cartoon XL
Nova Cartoon XL 是一个专注于卡通与动画风格的高质量 SDXL 模型,适合希望在 AI 生成图像中追求风格统一与视觉美感的用户。通过合理的参数设置与提示词搭配,你可以轻松生成令人惊艳的卡通风格作品。
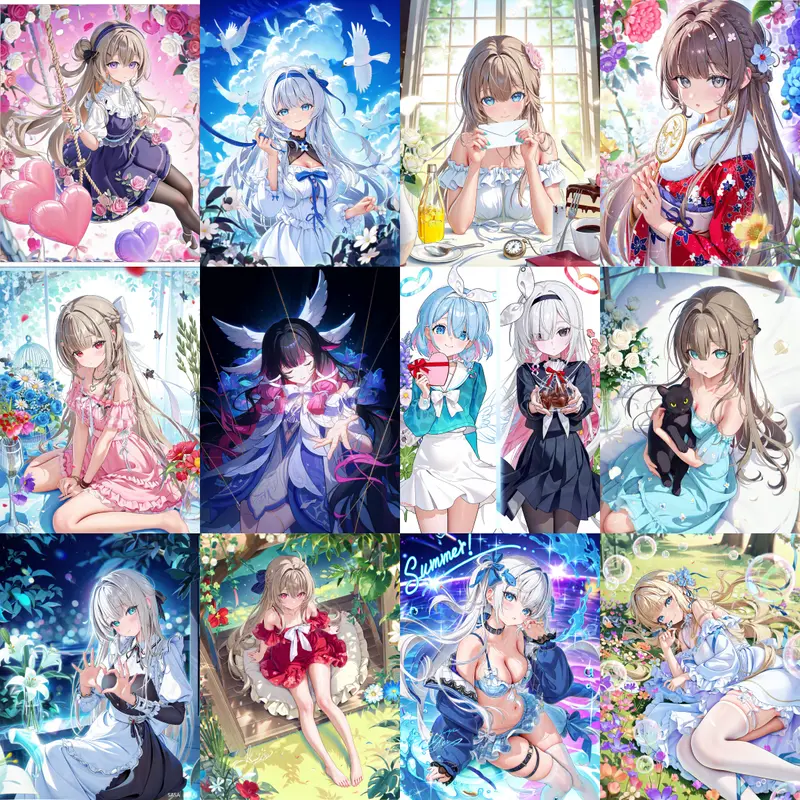
Z-Anime 是阿里巴巴 Z-Image Base 架构的完整微调版本——并非 LoRA 合并,而是从零开始构建的、专注于动漫风格的完整模型系列。
在 AI 绘画领域,动漫风格一直是最受欢迎但也最具挑战性的赛道之一。开发者SeeSee21正式推出 Z-Anime——一个基于 Z-Image Base 架构的完整微调模型系列。
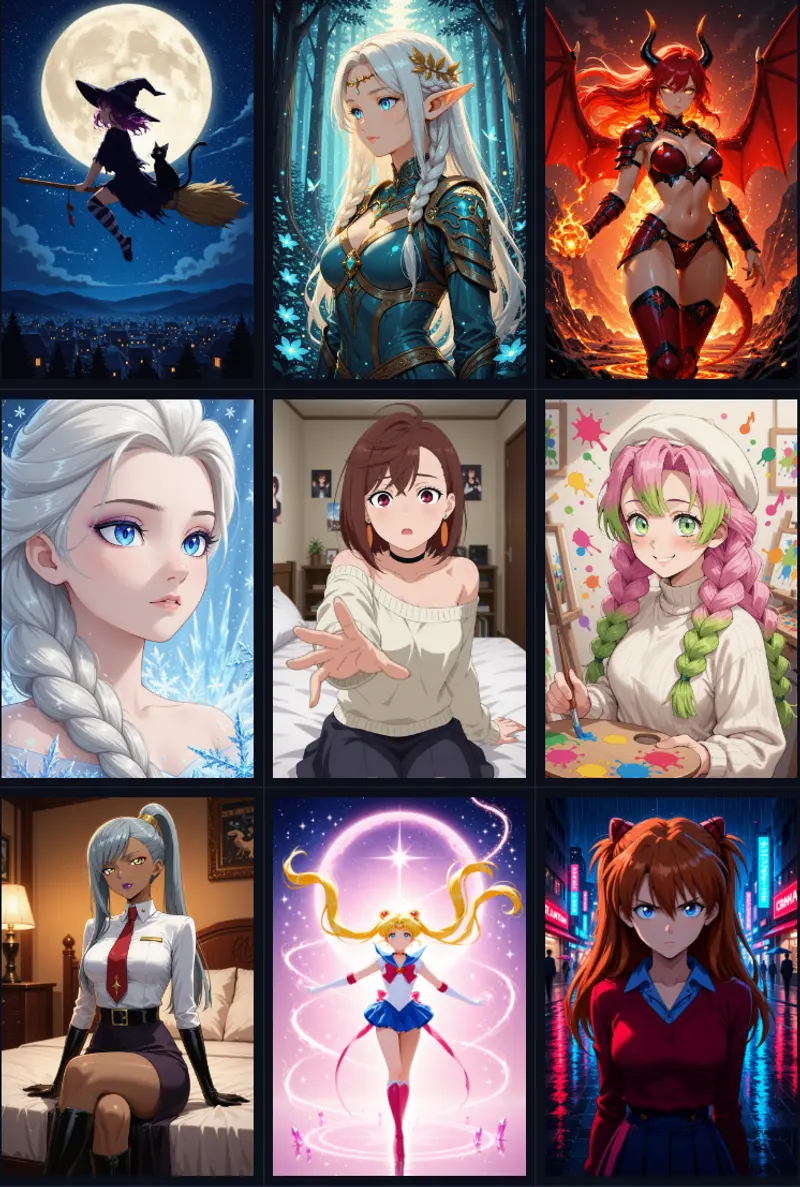
与常见的 LoRA 合并不同,Z-Anime 是从零开始构建的完整模型,基于 S3-DiT(单流扩散 Transformer,6B 参数)。它继承了 Z-Image Base 强大的多样性、可控性和负向提示支持,并专门针对动漫美学进行了深度优化。无论是精细的角色立绘,还是宏大的场景背景,Z-Anime 都能以极高的质量呈现。
Z-Anime 提供了多种变体,满足从专业创作到快速迭代的不同需求:
| 变体 | 侧重点 | 最佳用途 | 推荐步数 | CFG |
|---|---|---|---|---|
| 🎌 Z-Anime Base | 最高质量 | 最终渲染、精细作品、LoRA 训练基底 | 28-50 | 3.0-5.0 |
| ⚡ Distill-8-Step | 速度与质量平衡 | 日常生成、快速出图 | 8 | 1.0-1.5 |
| 🚀 Distill-4-Step | 极致速度 | 批量生成、原型设计、灵感捕捉 | 4 | 1.0 |
| 📦 GGUF 变体 | 低显存/CPU | 8GB 以下显存、AMD 显卡、CPU 推理 | – | – |
| 📦 AIO 变体 | 便捷部署 | ComfyUI 一键加载,无需单独配置 VAE/CLIP | – | – |
Z-Anime 最大的变革在于提示词逻辑。它不再依赖 masterpiece, best quality, 1girl... 这样的标签列表,而是推崇自然语言描述。
“A young anime girl with long silver hair and golden eyes, wearing a traditional shrine maiden outfit with white haori and red hakama. She stands in a sunlit bamboo forest, cherry blossoms falling softly around her. Warm afternoon light filtering through the trees, detailed fabric shading, expressive face, calm serene expression, high quality anime illustration with fine line work.”
“anime girl, silver hair, shrine maiden, bamboo, cherry blossom, warm light”
技巧:
Z-Anime 支持从 512×512 到 2048×2048 的任意宽高比,但以下分辨率经过特别优化:
CFG 指南(Base 版):
注意:蒸馏版(4-Step/8-Step)建议 CFG 固定为 1.0,最高不超过 1.5,否则极易产生伪影。
根据你的显存和需求选择版本:
ae.safetensors) + 文本编码器 (qwen_3_4b.safetensors)。.safetensors 文件(内含所有组件)。.gguf 文件 + VAE + 文本编码器。ComfyUI/models/diffusion_models/ComfyUI/models/vae/ComfyUI/models/clip/ComfyUI/models/checkpoints/ComfyUI/models/unet/Load Diffusion Model + CLIP Loader + VAE Loader。Checkpoint Loader,无需额外节点。