DigUp - 最新版
DigUp 是一款面向Apple芯片Mac的开源本地文件检索应用,依托Google DeepMind最新的多模态嵌入模型EmbeddingGemma 2,实现跨类型文件语义搜索。
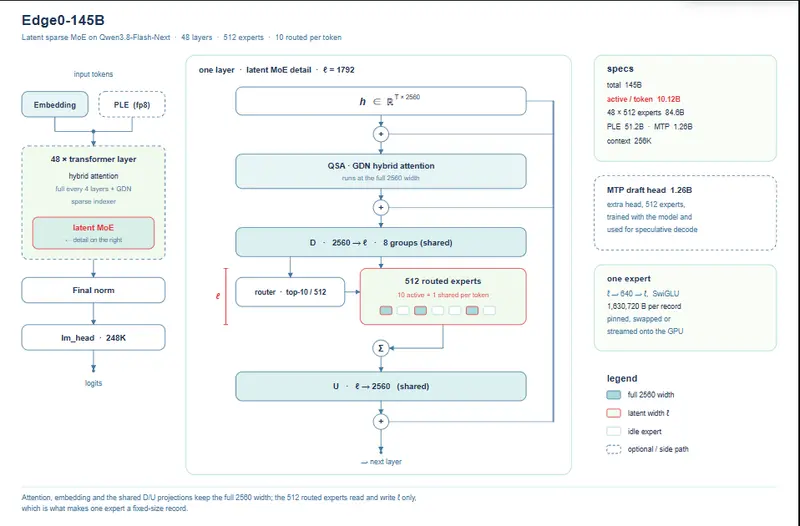
Edge0 正式发布其开源流式混合专家(MoE)推理框架,让大型稀疏模型能够在本地消费级硬件上高效运行。该框架支持 macOS、iOS、Android、Linux 和 Windows 等多平台,通过统一的 edge0-infer 工具链,为开发者提供命令行、本地 API 服务及桌面聊天应用等多种交互方式。最新版本的 Edge0-Strata 引擎更是实现了在单张 NVIDIA GPU 上运行 145B 和 120B 参数量的潜空间 MoE 模型。
Edge0 的最新亮点在于其针对超大参数模型的优化能力。基于 Qwen3.8-Flash-Next 架构,Edge0-145B 和 Edge0-120B 模型采用了原生 4 位训练技术,并提供 Q3_K 和 NVFP4 两种量化格式,专为本地 Agent 任务设计。
性能表现(RTX 5090 D 24GB):
| 模型型号 | 参数量 | 专家配置 | 引擎支持 | 推荐硬件 |
|---|---|---|---|---|
| edge0-145b | 145B | 48层, 512专家, K=10 | edge0-strata | Linux/Windows + NVIDIA GPU (CUDA 13) |
| edge0-120b | 120B | 48层, 512专家, K=10 | edge0-strata | Linux/Windows + NVIDIA GPU (CUDA 13) |
| edge0-35b | 35B | – | 原生引擎 (GGML) | CPU / Vulkan / Metal |
Edge0 采用双引擎架构以适配不同规模的模型与硬件环境:
注:8B 检查点已发布,但其在原生引擎上的支持仍在计划中。
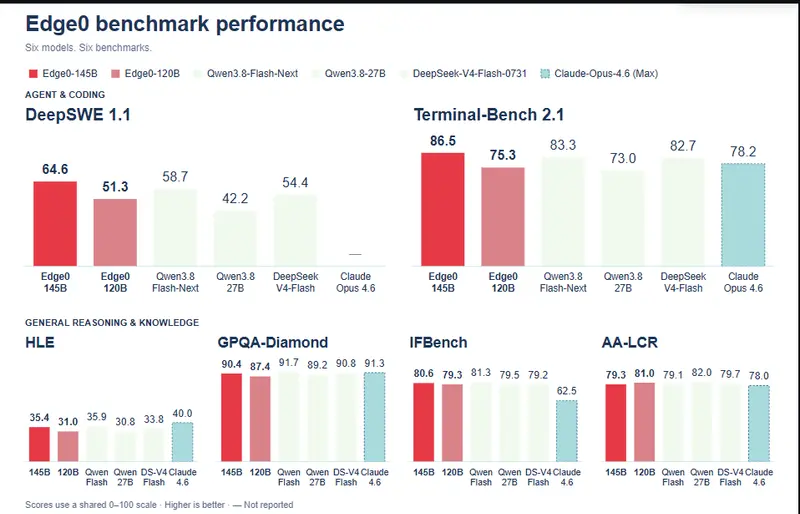
用户需分别构建 edge0-strata 引擎和 edge0-infer 工具。
git clone https://github.com/Edge0-AI/Edge0.git edge0
# 参照文档分别构建 edge0-strata 和 edge0-infer
edge0-infer 提供统一的 serve 和 chat 命令。以运行 Edge0-145B-q3k 为例:
启动 API 服务:
build/cpu/bin/edge0-infer serve --model /path/to/Edge0-145B-q3k
服务启动后,将监听 http://127.0.0.1:8000,并提供兼容 OpenAI 和 Anthropic 的接口。
测试接口:
curl localhost:8000/v1/chat/completions \
  -H 'content-type: application/json' \
  -d '{"model":"edge0_145b","messages":[{"role":"user","content":"hi"}],"max_tokens":64}'
启动交互式聊天:
edge0-infer chat --model /path/to/Edge0-145B-q3k
对于 Windows 用户,可直接从 GitHub Releases 下载 Edge0 Chat 桌面应用。打开应用后,选择对应的模型文件夹(如 Edge0-145B-q3k)即可实现零配置的本地运行。