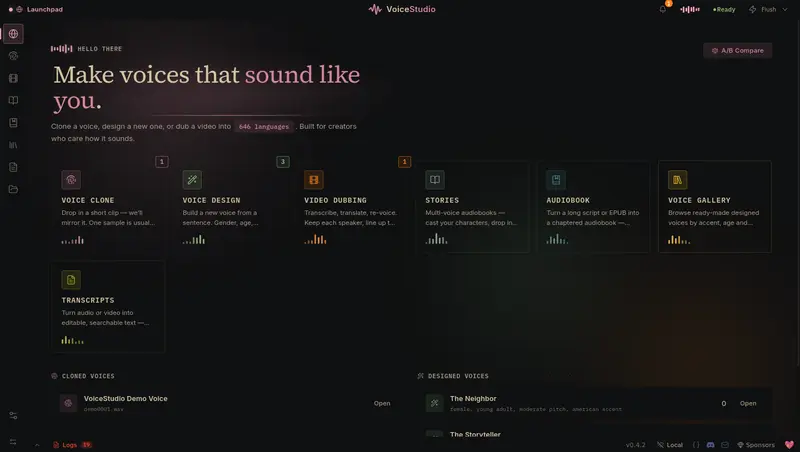
VoiceStudio 是一个免费、开源的桌面应用,将克隆、设计、配音、听写和有声书制作整合在一个界面中。核心流程完全在你的本地硬件上运行,支持 646 种语言,没有用量计费,也没有隐藏的云端依赖。

VoiceStudio 的核心理念是:声音很私人,创作空间也应该真正属于你。
八大核心功能
- 🎙️ 语音克隆:只需 3 秒音频即可零样本复刻任何声音,支持 646 种语言。
- 🎨 声音设计:精细调节性别、年龄、口音、音高、语速、情感和方言。
- 🎬 视频配音:导入 YouTube 链接或本地文件,自动完成转录、翻译、重新配音并导出 MP4。
- 📖 有声书编辑器:支持文本、EPUB 或 PDF 导入,自动分章、响度归一化并生成带元数据的 .m4b 文件。
- 🎭 故事模式:多角色配音编辑器,可逐行分配不同声音,预览并导出完整的配音阵容。
- ⌨️ 听写工具:全局快捷键(⌘+⇧+Space)触发,在任何应用中实现转录、自动粘贴并随即消失。
- 🔐 本地优先:所有核心创作数据留在设备内,联网服务仅为可选项。
- 🤖 MCP 服务器:可通过 MCP 协议被 Claude、Cursor 等 Agent 调用,实现自动化音频处理。
强大的扩展能力
除了主打功能,VoiceStudio 还内置了 12 项高级工具:
- 人声分离:基于 Demucs,从音乐中精准提取语音。
- 说话人分离:利用 Pyannote + WhisperX 自动识别“谁在什么时候说了什么”。
- 批量队列:拖入 50 个视频即可后台处理,每个任务独立显示进度。
- AI 水印:集成 Meta 的 AudioSeal,生成不可见且抗压缩的数字水印。
- GPU 自动检测与卸载:显存不足时自动将 TTS 任务卸载至 CPU,确保稳定性。
- 无限长 TTS:通过按句分块和 WebSocket 流式输出,突破生成长度限制。
引擎矩阵:14 个 TTS 与 10 个 ASR 的自由组合
VoiceStudio 不绑定单一模型,而是提供了一个强大的引擎选择器:
- TTS 引擎:默认使用支持 600+ 语言的 OmniVoice,同时可选装 CosyVoice 3、GPT-SoVITS、IndexTTS 2.5、MOSS-TTS 等 13 个引擎。无论是追求极速的 KittenTTS,还是追求情感表现的 IndexTTS,都能一键切换。
- ASR 引擎:默认使用词级对齐精准的 WhisperX,同时支持 Faster-Whisper、MLX Whisper(Apple Silicon 优化)、FunASR 以及 sherpa-onnx 实时听写等 9 个本地引擎。
开发者友好:OpenAI 兼容 API
VoiceStudio 内置了 OpenAI 兼容的音频 API 端点(http://localhost:3900/v1)。这意味着你可以直接使用现有的 OpenAI SDK 或脚本,将请求指向本地,无需修改代码即可享受本地推理的速度与隐私。
from openai import OpenAI
client = OpenAI(base_url="http://localhost:3900/v1", api_key="none")
result = client.audio.transcriptions.create(model="whisper-1", file=open("clip.wav", "rb"))
系统要求与兼容性
- 操作系统:Windows 10+、macOS 12+ (Apple Silicon)、Ubuntu 24.04+。
- 硬件:最低 4GB 显存(支持自动 CPU 卸载),推荐 8GB+ NVIDIA RTX 或 Apple Silicon。
- 注意:Intel Mac 用户需通过远程后端连接;AMD GPU 用户在 Linux 下可获得 ROCm 加速支持。