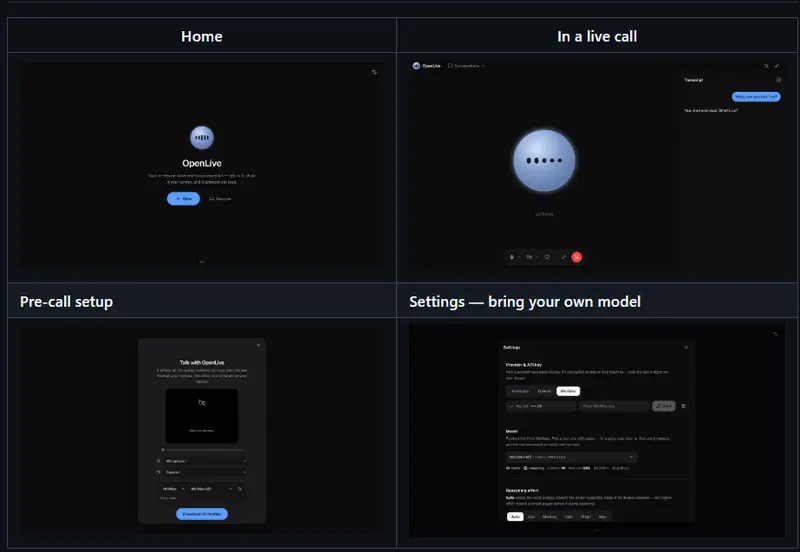
OpenLive 是一个开源的桌面应用框架,为 AI 智能体提供实时的语音和视觉交互能力。它充当了用户与大语言模型(LLM)之间的“感官接口”,将复杂的实时音频处理、视觉捕捉和对话管理逻辑封装在本地设备上运行。作为 ElevenLabs、Gemini Live 或 OpenAI Realtime 等封闭云服务的开放替代方案,OpenLive 强调隐私保护、零音频上传和用户对自己数据的完全控制。

核心理念:自带大脑,本地感官
OpenLive 的设计哲学是“分层解耦”:
- 你提供大脑:支持接入 Anthropic (Claude)、OpenAI (GPT-4o)、Google (Gemini)、xAI (Grok)、DeepSeek、Groq 以及本地运行的 Ollama 等数十家提供商的模型。
- OpenLive 提供感官:负责耳朵(语音活动检测、STT)、嘴巴(TTS)、眼睛(摄像头/屏幕共享)以及神经反射(打断机制、轮次管理)。
所有语音处理循环均在设备的 WebGPU 上本地运行,确保用户的音频数据永远不会离开本地机器,唯一上传至云端的仅是经过处理的文本提示。
核心功能特性
🎙️ 设备端实时语音循环
- 全本地处理:语音活动检测 (VAD)、流式语音转文本 (STT)、轮次结束检测和文本转语音 (TTS) 均在本地完成。
- 自然打断 (Barge-in):支持随时打断 AI 说话,AI 会立即停止并从半句话处重新响应,模拟真实的人类对话节奏。
- 零音频上传:彻底消除按分钟计费的音频处理成本,仅需支付模型本身的 API 费用。
👁️ 实时视觉感知
- 多源输入:支持开启摄像头或分享屏幕画面,让模型像视频通话一样“看见”当前环境。
- 高分辨率抓取:当需要识别细小文字(如代码行、标签)时,
look 工具会自动抓取清晰的高分辨率图像发送给模型进行推理。
🧠 灵活的模型集成
- 广泛兼容:开箱即用支持主流闭源及开源模型提供商。
- 透明选择器:界面显示各模型的视觉能力、推理强度、上下文窗口及价格信息。
- 推理调节:用户可手动调节推理强度,从“自动”到“最大”,以平衡速度与深度。
🛠️ 智能体工具与交互
- 实用工具集:内置网络搜索、URL 获取、跨调用记忆事实等功能。
- 系统级操作:在桌面应用中,智能体可读写剪贴板、打开 URL,实现更深层的系统交互。
- 浮动迷你模式:可缩小为始终置顶的小圆点,在工作时持续监听;摄像头和屏幕预览可堆叠显示,不干扰主工作流。
🔒 隐私与安全
- 数据本地化:会话历史本地保存,支持恢复之前的对话。
- 密钥保护:API Key 在静态存储时加密,界面上仅显示最后四位数字,防止泄露。
技术架构
OpenLive 的工作流如下所示:
graph LR
    A[麦克风] --> B[语音活动检测 VAD]
    B --> C[流式语音转文本 STT]
    C --> D[轮次结束检测]
    D --> E[您的 LLM 模型]
    E --> F[流式文本转语音 TTS]
    F --> G[扬声器]

    H[摄像头/屏幕] --> I[视觉帧处理]
    I --> E
- 渲染进程本地运行:除了模型推理外,所有音频处理和视觉预处理都在本地渲染进程中完成。
- 轻量代理通信:模型轮次通过热 WebSocket 发送到本地小代理,再由代理将回复流式传回应用,实现逐句播报和低延迟打断。
适用场景
- 隐私敏感型用户:希望使用 AI 语音助手但不愿将录音上传至第三方云服务器的个人或企业。
- 开发者与研究人員:需要构建自定义实时语音交互应用,但不想从头编写 VAD、STT 和打断逻辑的开发团队。
- 成本控制者:希望避免 ElevenLabs 等平台高昂的按分钟音频处理费用,仅为核心模型推理付费的用户。
- 多模态工作流:需要在编程、设计或日常办公中,让 AI 实时“看到”屏幕内容并提供语音反馈的专业人士。