llmfit
llmfit

llmfit最新版

官方版无广告189

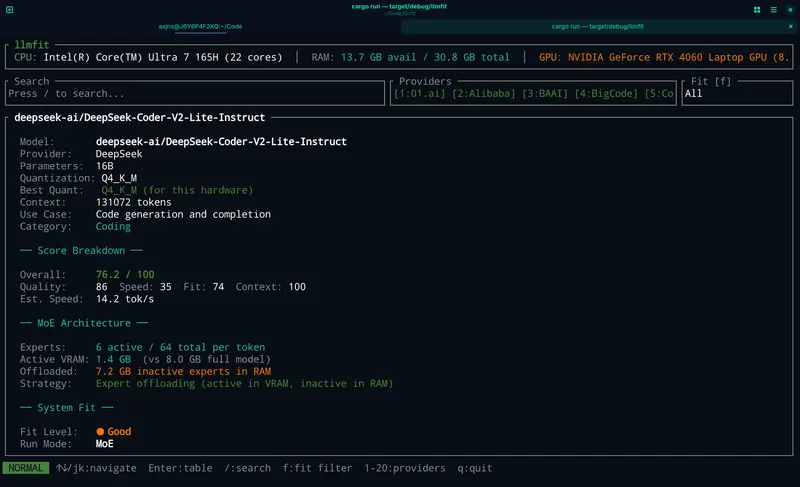
llmfit 是一款专为终端打造的智能工具,它能自动检测你的 CPU、RAM 和 GPU 配置,从全球 206 个热门模型(涵盖 57 个提供商)中,精准筛选出能在你机器上完美运行的模型,并给出速度与质量的最佳平衡建议。

更新日期:
2026年2月25日
语言:
中文
平台:

2.1MB0 人已下载 手机查看

在本地运行大语言模型(LLM)时,你是否常面临这样的困惑:

  • “我的 16GB 内存能跑 Qwen-72B 吗?”
  • “哪个量化版本能在我的 RTX 3060 上跑得最快?”
  • “MoE 模型到底省不省显存?”

手动计算显存需求、查阅评测、尝试不同量化版本不仅耗时,还容易出错。llmfit 是一款专为终端打造的智能工具,它能自动检测你的 CPU、RAM 和 GPU 配置,从全球 206 个热门模型(涵盖 57 个提供商)中,精准筛选出能在你机器上完美运行的模型,并给出速度与质量的最佳平衡建议。

llmfit

核心亮点:智能、精准、一站式

1. 全方位硬件感知

llmfit 不仅仅是看显存大小。它通过 sysinfo 和底层工具深入探测你的系统:

  • 多 GPU 支持:自动聚合 NVIDIA 多卡显存,支持 AMD ROCm 和 Intel Arc。
  • Apple Silicon 优化:精准识别 Mac 的统一内存架构,将系统 RAM 视为 VRAM 进行计算。
  • MoE 架构理解:智能识别混合专家模型(如 Mixtral, Grok),仅计算激活参数量,避免误判显存需求(例如将 47B 总参数的 Mixtral 正确评估为仅需约 13B 激活显存)。

2. 四维智能评分系统

每个模型都会经过严苛的四维评估,生成综合推荐分:

  • 适配度 (Fit):基于量化技术(Q8_0 到 Q2_K),计算模型是否能装入你的内存,并标记为“完美”、“良好”或“勉强”。
  • 速度 (Speed):根据后端(Metal, CUDA, ROCm)和参数量,估算每秒 Token 生成速度 (tok/s)。
  • 质量 (Quality):结合参数量、模型声誉及量化损失,评估输出质量。
  • 上下文 (Context):分析上下文窗口是否满足你的用例需求。

3. 交互式 TUI 与 Ollama 集成

  • 可视化操作:启动即进入精美的终端 UI (TUI),支持键盘导航、实时搜索、过滤(按适配度、用例)、排序和主题切换(Dracula, Nord, Gruvbox 等)。
  • 一键下载:检测到心仪模型后,直接按 d 键调用 Ollama 下载,无需切换窗口。已安装的模型会自动标记绿色对勾。
  • CLI 模式:支持脚本化调用,输出 JSON 格式结果,轻松集成到自动化工作流或 AI Agent 中。
llmfit

快速上手

安装 (macOS / Linux)

最简单的方式是一键安装脚本:

curl -fsSL https://llmfit.axjns.dev/install.sh | sh

或者使用 Homebrew:

brew tap AlexsJones/llmfit
brew install llmfit

安装 (Windows / 通用)

如果你已安装 Rust 环境:

cargo install llmfit

Windows 用户也可从 GitHub Releases 下载预编译的二进制文件。

开始使用

直接在终端输入:

llmfit

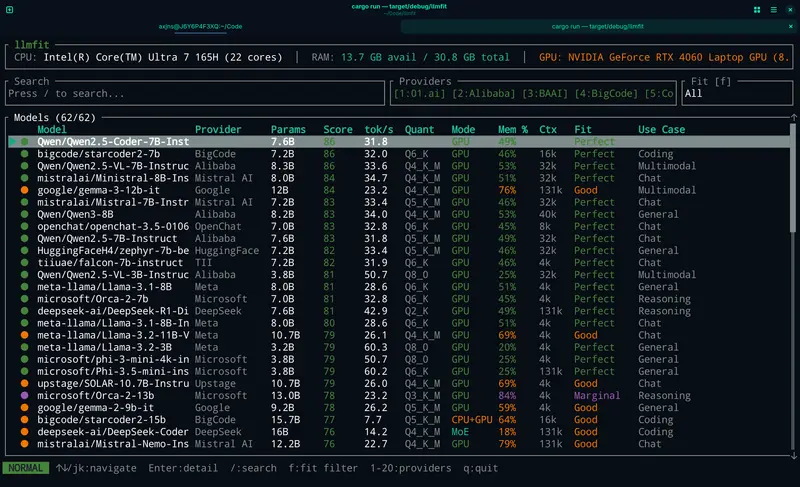
你将看到一个按综合分数排序的模型列表。顶部显示你的硬件概览(CPU、RAM、GPU、VRAM)。

常用快捷键:

  • /:搜索模型(支持名称、提供商、参数量)。
  • f:切换适配度过滤器(只看“完美”运行的模型)。
  • d:下载选中模型到 Ollama。
  • t:切换颜色主题。
  • Enter:查看模型详细信息(量化建议、预计显存占用、速度估算)。

高级功能:解决疑难杂症

  • 手动指定显存:如果自动检测失败(常见于某些 Linux 发行版或特殊显卡),可手动覆盖:
    llmfit --memory=24G
    
  • 场景化推荐:通过 CLI 获取特定用途的推荐(如编程、推理):
    # 获取前 3 个最适合编程的模型(JSON 格式)
    llmfit recommend --json --use-case coding --limit 3
    
  • OpenClaw 智能体集成:
    llmfit 内置了 OpenClaw 技能 llmfit-advisor。安装后,你可以直接问你的 AI 助手:“帮我选一个适合写代码的本地模型”,它会自动调用 llmfit 分析硬件并配置好 Ollama。

工作原理揭秘

llmfit 的强大源于其严谨的计算逻辑:

  1. 动态量化选择:它不会只检查 FP16 精度。它会从最高质量的 Q8_0 开始向下遍历,找到能塞进你显存的最高质量量化版本。如果全上下文放不下,它甚至会计算半上下文下的运行情况。
  2. 速度估算模型:基于特定后端的常数因子,结合参数量和量化类型,公式化估算 tok/s,让你对运行速度有心理预期。
  3. 实时数据库:内置的模型库通过脚本定期从 HuggingFace API 抓取更新,涵盖 Llama 3, Qwen 2.5, Mistral, Gemma, Phi-3 等主流系列。

相关软件

Ollama

Ollama - 最新版

Ollama 是一个开源的框架,专门设计用于简化在本地机器上部署和管理大语言模型,Ollama 提供了简单的命令行界面(CLI),用户可以通过一条命令快速启动和运行大型模型,支持多种预构建的模型。
PocketPal AI

PocketPal AI -

PocketPal AI 是一款开源的 AI 助手应用,专为 iOS 和 Android 用户设计。它通过小型语言模型(SLM)直接在你的手机上运行,让你无需互联网连接即可与各种 AI 模型进行交互。这款应用不仅提供了强大的功能,还确保了数据的安全性和隐私性。
Alma

Alma - 最新版

Alma 是一款桌面 AI 聊天应用,提供对多个 LLM 服务商的统一访问。Alma 让你可以通过单一、优雅的界面访问 ChatGPT、Claude、Gemini 等多个 AI,而无需在不同的应用和界面之间切换。