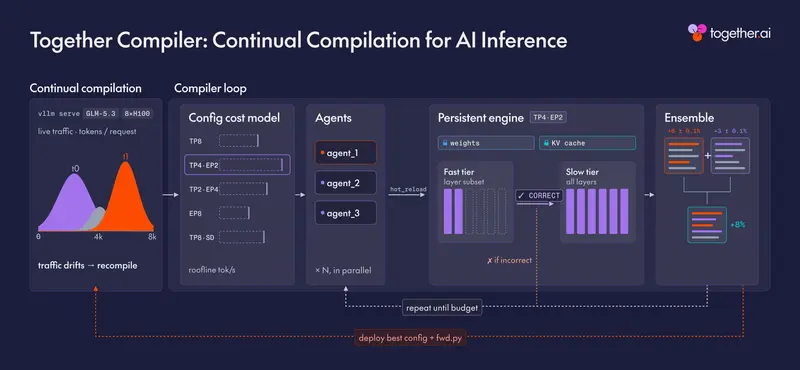
Together AI推出了 Together Compiler (TKCC),这是一个由智能体(Agent)驱动的持续推理优化系统。该系统通过动态重写模型的前向传播代码,并配合持久化引擎进行热重载评估,使大模型推理能够随着真实生产流量的变化而持续自我优化,打破了传统静态推理引擎的性能瓶颈。
- 官方介绍:https://www.together.ai/blog/together-compiler-continual-compilation-for-ai-inference
核心机制与技术突破
TKCC 的核心创新在于将“编译优化”从一次性的人工调优,转变为自动化、持续运行的闭环系统:
- 持续编译与流量自适应:系统接收服务器、流量与硬件配置后,编码智能体会自动生成并尝试更快的前向传播实现。当生产环境中的流量特征(如上下文长度分布、MoE 专家激活模式)发生漂移时,优化循环会自动重新运行,确保引擎始终处于最优状态。
- 持久化引擎与热重载(Hot-Reload):传统智能体优化每次实验都需重启推理框架(如 vLLM 或 TensorRT-LLM),冷启动耗时极长(如 MiniMax 模型需 761 秒)。TKCC 的持久引擎仅启动一次,智能体通过 RPC 提交候选代码,服务器直接交换前向函数指针并重捕获 CUDA 图,使智能体实验吞吐量比传统重启基线提升了 252 倍。
- 双层测量与成本模型:采用“12 层快速筛选 + 60 层慢速确认”的双层评估机制,在保证保真度的同时大幅扩大搜索空间(候选测试量提升 8.1 倍)。此外,成本模型会在智能体探索前,结合硬件规格、微基准及真实的 MoE 专家不平衡数据,对并行布局(张量、专家、数据、上下文)进行预排名。
- “朴素”智能体优于专家规则:实验表明,直接向智能体提供原始引擎源代码并设定“尽可能快”的目标,其表现优于依赖人工策划知识库的策略(集成得分 6.2 倍 vs 4.9 倍),证明了端到端自主探索的强大潜力。
性能表现与基准测试
在 SemiAnalysis InferenceX 的 AgentX 工作负载上,TKCC 在每种设置下运行不到 24 小时,其吞吐量(TPS)相比当前最佳开源配置实现了显著跃升:
- MiniMax M3.1 Flash (NVIDIA B200, 批大小 1):P90 TPS 达到 1,111,较基线 633 TPS 提升 1.8 倍(成本模型智能选择了 TP8 布局以减半内存受限解码时的权重流量)。
- DeepSeek v4.1 Flash (GB300):P90 TPS 达到 1,205,较基线 943 TPS 提升显著。
- GLM 5.3 (B200):TPS 从 329 提升至 417。
- 科学计算模型:除 LLM 外,TKCC 还在保持位精确输出的前提下,将 8 个科学模型的推理速度加速了 1.5 倍至 6.4 倍。
(注:在部分特定硬件与模型组合下,如 MI355X 上的 GLM 5.3,增益约为 4%,表明优化收益受具体硬件架构与模型特性影响。)
© 版权声明
文章版权归作者所有,未经允许请勿转载。