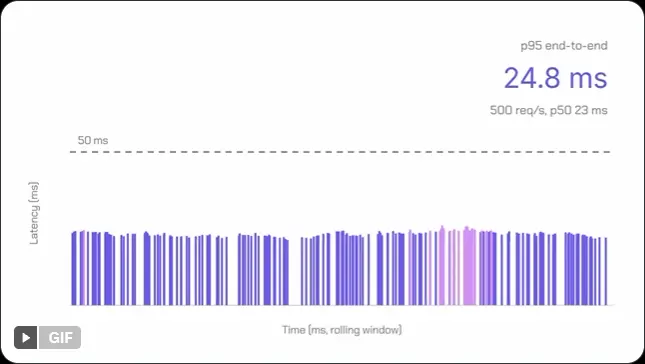
Liquid AI今天正式发布了 Liquid RIPL(实时推理管道,Real-time Inference Pipeline)。这是一个专为低延迟场景构建的推理引擎,旨在将 Liquid Foundation Models (LFMs) 直接无缝集成到企业的实时请求路径中。该引擎能够在端到端不到 50 毫秒的时间内返回完整的生成模型响应,并且在流量达到峰值负载时依然能保持这一性能表现。
- 地址:https://www.liquid.ai/low-latency-calculator-ripl
打破实时工作负载的延迟瓶颈
当前的许多服务基础设施是为通用模型、大批量处理或长时间运行的代理工作流设计的,在这些场景中,几秒钟的响应时间是可以接受的。然而,企业级实时工作负载(如搜索排名、产品推荐、欺诈检测、支付授权等)拥有极小的延迟预算。即使是微小的延迟增加,也会给用户体验带来摩擦(例如,结账速度变慢会直接损害转化率)。因此,这些系统传统上不得不依赖速度较快但准确性较低的替代方案,如梯度提升树或小型嵌入模型。
Liquid RIPL 的出现改变了这种“速度与准确性”的取舍。它专为实时约束而构建,旨在提供更快、响应更灵敏的生成式 AI 体验,从而改善客户在搜索、发现、交易和互动环节的体验。
卓越的性能表现与基准对比
在延迟敏感的企业工作流中,Liquid RIPL 展现出了显著的性能优势。根据官方提供的基准测试数据:
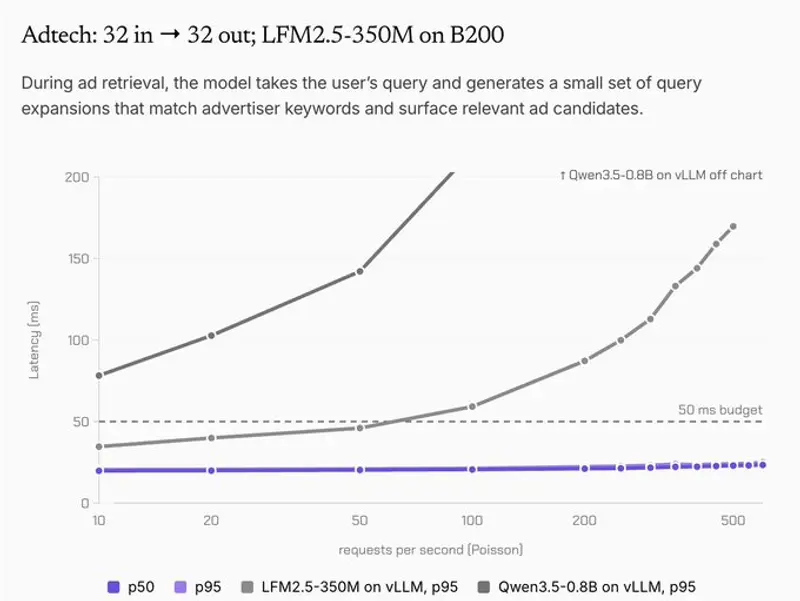
- 在 RIPL 上运行的 LFM2.5-1.2B 模型,其 p95 延迟比在 vLLM 上运行的 Qwen3.5-0.8B 模型低 14.4 至 28.4 倍。
- LFM2.5-2.6B 模型的 p95 延迟,也比在 vLLM 上运行的 Qwen3.5-2B 模型低 5.6 至 7.7 倍。
生产环境验证:Shopify 案例
Liquid RIPL 的能力已在真实的生产环境中得到验证。例如,Shopify 正在其延迟敏感的商务工作负载中部署 LFM。在搜索增强等真实生产场景中,LFM 实现了低于 20 毫秒的推理延迟。值得注意的是,使用参数量减少约 50% 的 LFM,不仅在不损害质量的前提下优于传统替代方案,还提供了 2 到 10 倍的推理速度提升。这证明了高效、任务专用的模型在与高性能推理引擎(如 RIPL)结合时,能够大规模交付极低的端到端延迟和高吞吐量。
部署与支持
目前,Liquid RIPL 已可用于 NVIDIA GPU(如 H100、H200、B200 或 RTX PRO 6000)上的 LFM 企业级部署。对于任何具有严格延迟预算的请求路径,RIPL 提供了一个可靠的高性能解决方案,帮助企业在不牺牲生成式 AI 能力的情况下,满足毫秒级的业务响应需求。
© 版权声明
文章版权归作者所有,未经允许请勿转载。