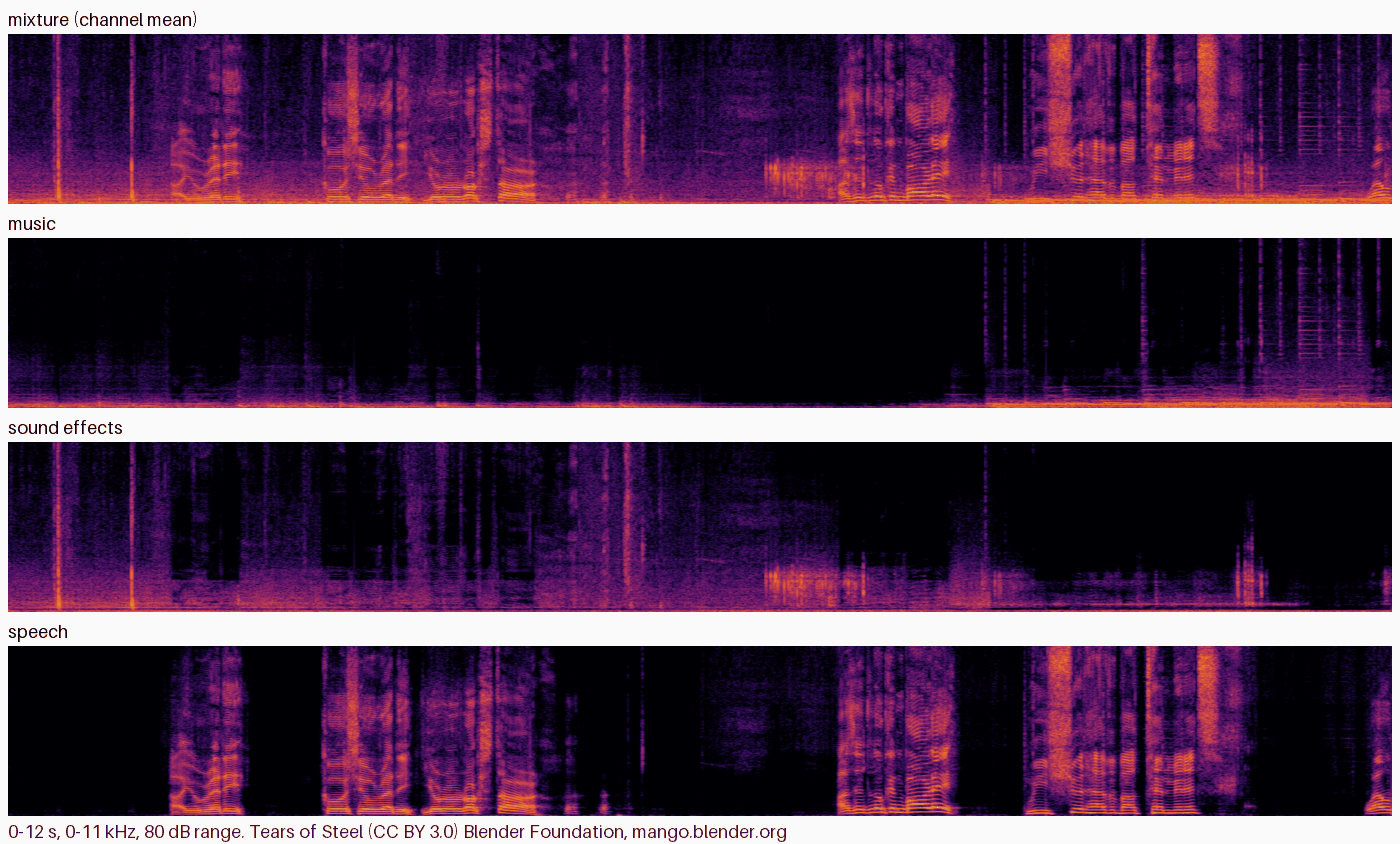
ComfyUI-DBS 是一个用于 ComfyUI 的非官方节点包,实现动态频带分割(DBS)。它基于 JusperLee 的 Dynamic-Band-Splitting 论文,能够将混合配乐精准分离为音乐、音效和语音三个独立音轨。
- GitHub:https://github.com/hiroki-abe-58/ComfyUI-DBS
对于视频创作者而言,这意味着可以直接在 ComfyUI 工作流中移除视频对话以保留纯背景音乐和音效,或者单独提取人声用于配音与转录,甚至重新平衡混音。
核心机制与节点功能
该方案的优势在于极低的资源占用。模型参数量仅为 1.0M(DBS-TIGER-DnR)和 4.7M(DBS-BSRNN-DnR),支持在 CUDA 或 CPU 上运行。分离出的三个音轨(stems)相加后,与原始输入的误差约为 1e-6,保证了信号的完整性。节点内置了官方代码,运行过程中不会自动下载任何外部内容。
包内包含两个核心节点:
- DBS Loader:用于选择模型及运行设备。设备设为 auto 时,若 ComfyUI 检测到 CUDA GPU 则优先使用,否则回退至 CPU。
each channel**:对每个声道单独分离,保留立体声,但处理时间会加倍。
模型原生工作在 44.1 kHz 采样率。如果输入音频采样率不同,节点会调用 ComfyUI 自身的重采样器进行处理,输出时可选择保持 44100 Hz 或重采样回原始采样率。此外,它采用了模型卡推荐的重叠相加(overlap-add)窗口策略,支持任意长度的音频输入,且按项目逐个进行批次分离。
性能表现与硬件选择
根据实测数据,两个模型在不同硬件上的表现差异明显:
- DBS-TIGER-DnR (1.0M):在 RTX 5090 上可达到 16 倍实时处理速度;但在 CPU(24 线程)上仅为 0.5 倍实时速度,处理时间约为音频长度的两倍。
- DBS-BSRNN-DnR (4.7M):在 RTX 5090 上达到 22 倍实时速度;在 CPU 上表现更为实用,达到 1.8 倍实时速度。
如果没有配备 CUDA GPU,DBS-BSRNN 是更务实的选择。
部署与工作流配置
运行该节点需要 ComfyUI v0.38.0 或更高版本(支持 V3 节点 API)以及 Python 3.10+。
- 安装依赖:将仓库克隆至
ComfyUI/custom_nodes/目录,并安装requirements.txt(主要包含einops和safetensors,通常 ComfyUI 已自带)。 - 下载模型:运行提供的
download_model.py脚本。该脚本会固定修订版并验证 SHA-256,下载两个共计约 23 MB 的模型文件至models/dbs目录。 - 加载工作流:重启 ComfyUI 后,可直接加载包内提供的预设工作流:
separate_soundtrack.json:输出三个独立的 FLAC 音轨。remove_dialogue.json:合并音乐与音效,分离出无对话的配乐和人声,保持立体声和原始采样率。video_remove_dialogue.json:针对视频文件,输出带有无对话配乐的新视频。
验证情况与使用边界
该节点包在 Windows 11、ComfyUI v0.38.0 环境下进行了严格验证。在 CPU 模式下,其输出与官方包逐字节相同;在开启 PyTorch 确定性算法的 CUDA 模式下,同样实现了逐位一致。
但在使用时需注意以下限制:
- 训练数据局限:模型基于 DnR v2 数据集训练,主要针对英语语音、音乐和音效的电影配乐混合场景。对于带人声的歌曲、非英语语音或人声与音乐极度混杂的音频,分离效果需自行评估。
- 中断处理:处理中断会在两个窗口之间停止,不会破坏已处理部分。
- CUDA 确定性:在 CUDA 环境下,重复运行可能在文件末尾产生微小的字节差异(官方代码亦如此)。若需每次生成完全一致的文件,需使用
--deterministic参数启动 ComfyUI。 - 未验证环境:目前未在 Linux、macOS 以及 AMD 或 Apple GPU 上进行测试(在这些环境下包将回退使用 CPU)。此外,包仅验证了对官方输出的复现能力,未对分离质量本身进行独立重新评估。
© 版权声明
文章版权归作者所有,未经允许请勿转载。