在Windows and Surface十月新品活动上,微软公布GitHub Copilot将新增本地AI模型支持,本月底正式实现云端模型与本地模型之间智能调度选择,Copilot会在后台自动完成推理编排,开发者无需手动管理底层基础设施。这套混合推理方案搭配MAI Code 1.1 Flash设备端模型,在搭载NVIDIA RTX Spark硬件的全新Surface Laptop Ultra上优先落地。
原有模型编排体系与升级逻辑
当前GitHub Copilot的请求大多交由云端托管模型处理,依靠编排器综合性能、成本、准确率来路由请求,此前已有Project HydraFusion多模型工作流用于调度与负载平衡。本次更新进一步拓展能力边界,新增本地设备端模型作为推理选项。
内存是本地运行AI编码模型的核心瓶颈,包含GPU显存以及CPU、GPU共享的统一内存。随着上下文不断增长,内存占用持续走高,容易拖慢响应速度,MAI Code 1.1 Flash便是针对该痛点设计。
MAI Code 1.1 Flash模型细节
MAI Code 1.1 Flash为专家混合架构,总参数量1370亿,激活仅68亿参数。依托量化、推测解码等技术,降低内存占用、提升响应速度。微软在Surface Laptop Ultra设备上实测,该模型在峰值内存占用、Token利用率以及复杂任务处理上都有明显优化。
Copilot使用模式与接入方式
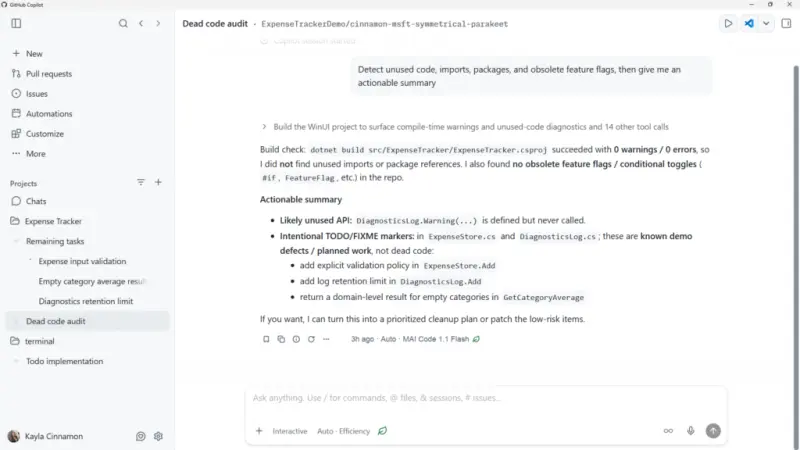
开发者在GitHub Copilot应用、Copilot CLI、VS Code内拥有两种控制模式:Auto自动编排模式,由Copilot自主判断选择本地或云端推理;也可以强制指定全程使用设备端本地模型。
模型接入途径灵活:可通过Windows ML提供程序直接调用MAI Code 1.1 Flash,也能把Copilot对接任意OpenAI兼容本地端点,调用本地部署的各类模型。
安全隔离:MXC作为底层沙盒
本地模型执行工具链由Microsoft Execution Containers(MXC)做安全管控,统一账户策略会自动转换成对应操作系统原生权限限制。不同平台采用不同隔离后端:Windows使用ProcessContainer的BaseContainer层级;Linux使用bubblewrap;macOS依靠Seatbelt。微软还规划在后续版本增加独立虚拟机、容器镜像作为隔离选项。
要点小结
- 核心更新:GitHub Copilot本月底上线本地+云端混合推理编排,自动调度模型,开发者可自主控制推理策略。
- 设备端模型:MAI Code 1.1 Flash,MoE架构,总参1370亿,活跃参68亿,依靠量化与推测解码优化内存与响应速度,适配Surface Laptop Ultra。
- 操作模式:支持Auto自动选择,或强制本地推理;兼容Windows ML与OpenAI标准本地端点。
- 安全底座:基于MXC容器治理AI代理执行环境,跨平台适配不同系统原生沙盒机制,后续将新增虚拟机隔离方案。
- 适用场景:在高性能Windows设备上离线完成编码任务,复杂需求依旧可无缝切回云端大模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。