OpenAI 即将推出 GPT-Bidi-1:ChatGPT 语音模式迎来重大升级,支持双向实时音频流与智能中断处理,缩小文本与语音智能差距,引入高/中/即时三档推理层级
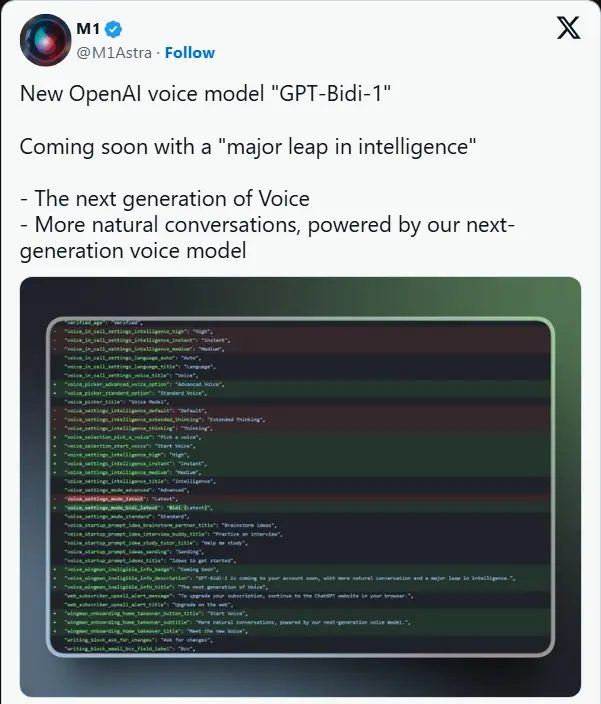
OpenAI 正准备为 ChatGPT语音模式带来数月来最大规模的升级,核心是引入一款暂定名为 GPT-Bidi-1 的下一代双向音频模型。这一更新不仅旨在提升语音质量,更致力于缩小文本模型(已达 GPT-5.5 水平)与语音交互之间的智能差距,标志着 OpenAI 向“语音即主要交互界面”的战略愿景迈出了关键一步。
核心亮点:双向实时、智能中断、推理分层
1. 真正的双向实时交互 (Bidi Architecture)
- 同时听与说:GPT-Bidi-1 采用双向架构,能够像人类一样在说话的同时监听用户反馈,而非传统的“说完再听”模式。
- 智能中断处理:模型能敏锐捕捉用户的打断信号(如“嗯哼”、插话),并动态调整当前生成的句子,而不是机械地停顿或忽略,使对话流动更加自然流畅。
2. 智能层级选择
- 速度 vs 深度:借鉴文本端的经验,语音模式将引入 高 (High)、中 (Medium)、即时 (Instant) 三种智能层级。
- 即时:追求极低延迟,适合简单问答。
- 高:牺牲少量速度以换取更深的推理能力,适合复杂任务。
- 用户自主权:用户可根据任务需求灵活切换,平衡响应速度与回答质量。
3. 平滑过渡与兼容
- 模式并存:用户不会被强制迁移,可在新的 Bidi 模式与当前的先进语音模式之间自由切换。
- UI 微调:近期允许将语音气泡拖至屏幕中央的改动,可能是为新交互范式做的视觉铺垫。
战略意义:填补文语鸿沟,押注音频未来
| 维度 | 现状 | GPT-Bidi-1 升级后 |
|---|---|---|
| 智能水平 | 文本 (GPT-5.5) >> 语音 (旧堆栈) | 文本 ≈ 语音,实现能力对齐 |
| 交互方式 | 轮流发言,机械停顿 | 双向并行,支持自然打断与修正 |
| 战略定位 | 文本为主,语音为辅 | 语音作为主要交互入口,为音频硬件铺路 |
OpenAI 认为,语音而非文本,将成为人们接触 AI 的主要方式。GPT-Bidi-1 正是围绕这一赌注构建的,它不仅是一个更好的语音助手,更是未来 音频优先硬件 和 基于语音的支持工具 的核心引擎。
发布时间与展望
- 临近发布:网页端和移动端的代码迹象表明,面向消费者的发布已近在咫尺,可能在本周或稍晚时候开始推送。
- 名称待定:GPT-Bidi-1 仅为内部暂定名,正式发布时可能会有所调整。
© 版权声明
文章版权归作者所有,未经允许请勿转载。