谷歌正在将其 Gemini 应用 的图像生成能力提升到一个新的高度,通过深度整合 个人智能 (Personal Intelligence)、Google Photos 以及最新的 Nano Banana 2 模型,实现了真正“量身定制”的视觉创作体验。
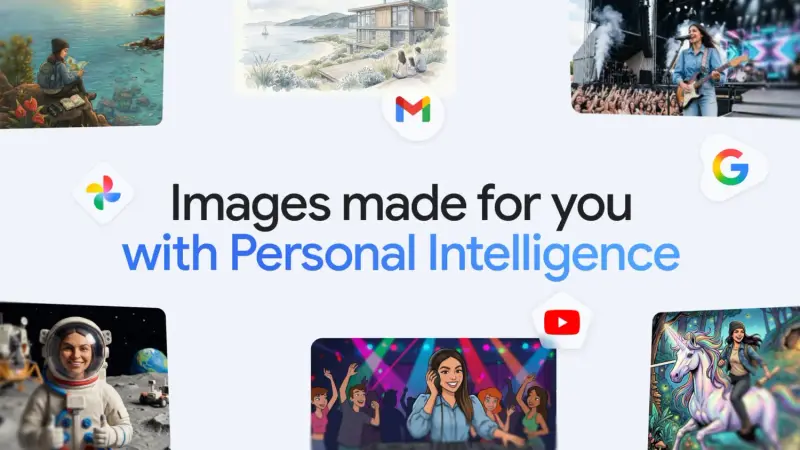
这一更新旨在彻底改变用户与 AI 交互的方式:不再需要编写冗长复杂的提示词或手动上传参考图,Gemini 将自动利用你的个人数据上下文,生成极具个人色彩和意义的图像。
核心亮点:从“通用生成”到“私人定制”
1. 个人智能自动填充上下文
- 理解你的品味:Gemini 会分析你过去的聊天历史和互动偏好,自动捕捉你的审美风格、兴趣点和生活方式。
- 无需赘述:系统会自动填补提示词中的空白。例如,如果你常说喜欢“极简主义”或“赛博朋克”,Gemini 会在生成图像时默认应用这些风格,无需每次重复说明。
2. Google Photos 深度集成
- 真实人物与宠物识别:如果你已授权 Gemini 访问 Google Photos,它可以识别库中的人物(家人、朋友)和宠物标签。
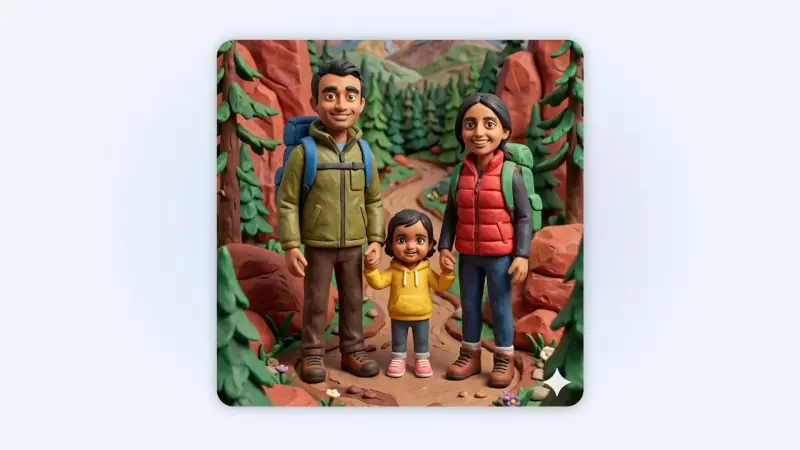
- 场景化创作:你可以直接说:“创建一个我和家人在享受我们最喜欢的活动时的粘土动画图像。”
- Gemini 会自动从 Photos 中提取你和家人的面部特征。
- 它会识别你们常做的“最喜欢活动”(如 hiking, cooking, gaming)。
- 结合 Nano Banana 2 的强大生成能力,输出高度个性化的结果。
3. Nano Banana 2 模型加持
- 高质量生成:作为谷歌最新的图像生成模型,Nano Banana 2 提供了更高的保真度、更好的指令遵循能力以及更丰富的风格表现力。
- 风格多样化:支持从写实摄影到粘土动画、水彩画等多种艺术风格的高质量转换。
透明度与控制权
为了确保用户对生成过程的控制,Gemini 引入了新的透明机制:
- “来源”按钮 (Source Button):点击该按钮,用户可以查看 Gemini 自动选择了哪张照片或哪些数据来指导本次创作。
- 手动修正:如果 Gemini 选择的参考图不符合预期,用户可以手动切换或提供更具体的指令。
- 隐私保护承诺:
- 不用于训练:谷歌明确声明,不会直接使用你私密的 Google Photos 库内容来训练其基础大模型。
- 有限改进:仅使用有限的交互数据(如特定提示和模型响应)来优化个性化功能本身,且经过严格脱敏处理。
可用性与发布计划
- 首批用户:未来几天内,面向 美国地区 的 Google AI Plus, Pro 和 Ultra 订阅用户推出。
- 后续扩展:
- 即将登陆 Chrome 浏览器中的 Gemini。
- 逐步向更多国家和地区的用户开放。
- 随着国际扩展的进行,更多语言和本地化支持将陆续上线。
© 版权声明
文章版权归作者所有,未经允许请勿转载。