新词元所
词元所是连接模型供应方与消费方的模型撮合交易服务平台,提供海量可信模型资源、实时数据排行、质量参数监测、可信认证等能力。
Marktechpost 推出 GPU Leaderboard,一款免费云 GPU 推理价格对比工具,同步发布配套 Chrome 扩展 GPU Leaderboard: Deploy It。平台直接抓取各家服务商官方定价页的按需、现货价格,目标是一站式帮助开发者匹配 GPU 规格、找到性价比最高的租赁方案。
 GPU Leaderboard
针对 AI 开发者在云端部署模型时面临的价格不透明与硬件选型难题,Marktechpost AI 正式发布了 GPU Leaderboard 及其配套的 Chrome 扩展程序 Deploy It。该工具集通过聚合 24 家云提供商的实时定价数据,旨在回答“运行特定模型需要什么 GPU”以及“哪里最便宜”这两个核心问题。
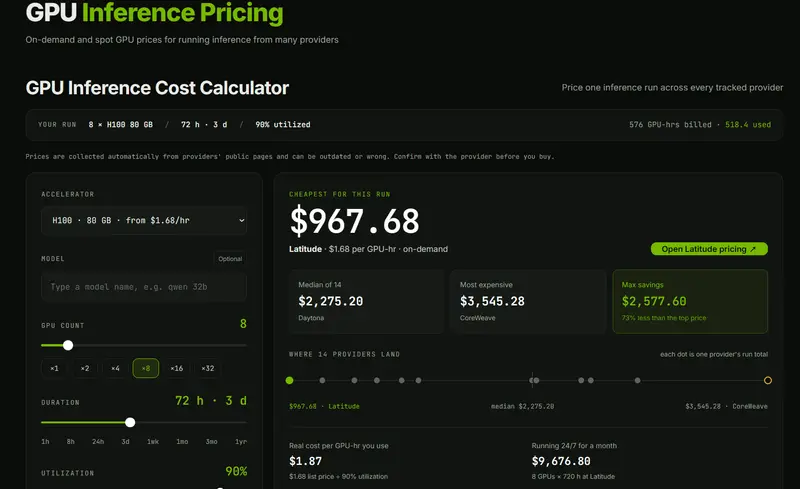
GPU Leaderboard v1 版本提供了一个综合定价仪表板,其核心差异在于不仅展示单一的每小时费率,更侧重于计算完整推理任务的总成本。平台目前追踪 201 个实时 GPU 报价,并按每 GPU 小时价格进行排名。
主要功能视图:
“真实”成本核算逻辑:
大多数预算表往往忽略空闲时间的计费。GPU Leaderboard 引入了“每已用 GPU 小时”的真实成本概念。例如,在默认示例中(8×H100 运行 72 小时,利用率 90%):
为了缩短从模型发现到部署决策的路径,Marktechpost 推出了 Deploy It Chrome 扩展。该扩展直接在开发者浏览模型代码或文档时提供硬件估算与价格参考。
支持场景:
与早期的 GPU 价格追踪器相比,GPU Leaderboard 的优势在于每日刷新频率和更广泛的覆盖范围。然而,其当前版本仍存在一些局限:
尽管存在上述限制,GPU Leaderboard 通过引入利用率修正后的真实成本计算,为团队提供了更具参考价值的预算依据,而 Deploy It 则进一步将这一能力嵌入到了日常开发工作流中。