加州大学伯克利分校 Sky Computing Lab 近期开源了 LEANN,一种专为降低存储占用而设计的向量索引方案。该研究通过“在查询时重新计算嵌入”的创新机制,有效解决了传统检索增强生成(RAG)系统中向量索引体积往往大于原始数据的问题。该论文已荣获 MLSys 2026 最佳研究论文奖。

核心机制:按需重计算与多级优化
传统图索引(如 HNSW)需要将完整的向量数据常驻内存,导致存储开销巨大。LEANN 的核心思路是保留一个剪枝图与紧凑的产品量化(PQ)表,丢弃完整向量,仅在查询时按需重建搜索路径上的节点嵌入。
为确保这一过程不会严重拖慢搜索速度,LEANN 引入了三项关键技术优化:
- 两级搜索策略:首先使用低成本的 PQ 距离对邻居节点进行初步排名,随后仅对排名靠前的顶级候选者进行精确的嵌入重计算,大幅减少不必要的算力消耗。
- 动态批处理:将来自多跳搜索的候选节点进行分组(例如每次 64 个),以更好地利用 GPU 的并行计算能力,提升整体吞吐量。
- 高度保留剪枝:对图结构进行非对称优化。大多数普通节点仅保留极少量的边,而前 2% 的高频“枢纽”节点则保留更多连接,以维持图的连通性与检索效率。
消融实验表明,两级搜索可带来平均 1.4 倍的加速,结合动态批处理后加速比提升至 1.8 倍。
基准测试:存储大幅缩减与准确率对齐
研究团队在包含 6000 万个段落的 RPJ-Wiki 数据集上进行了严格测试。在 90% 召回率(Recall@3)的标准下,LEANN 展现了明确的存储优势与可接受的延迟代价。
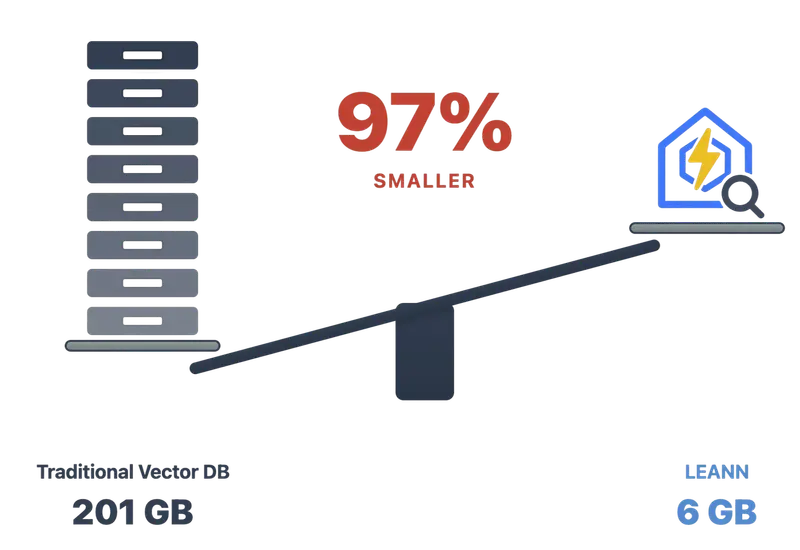
- 存储占用:在默认使用 Contriever(1.1 亿参数)作为嵌入器的情况下,6000 万块数据的索引体积从 201 GB 骤降至 6 GB。在论文所述的 76 GB 语料库设置中,存储需求仅为 4 GB,远低于 HNSW 所需的 188 GB。
- 准确率表现:在 NQ 数据集上,配合 Qwen3-4B 模型,LEANN 与 HNSW 均达到了 25.5% 的下游准确率,显著优于 BM25(18.3%)和传统 PQ 压缩(17.9%)。
- 延迟代价:存储的缩减不可避免地增加了检索时间。在 RTX 4090 环境下,LEANN 在 NQ 上的检索耗时为 2.48 秒,而 HNSW 为 0.05 秒。然而,考虑到后续生成阶段通常耗时约 20 秒,端到端总延迟仅从 20.95 秒微增至 23.34 秒,对整体用户体验影响有限。
主流向量索引方案横向对比
以下数据基于 LEANN 论文在 RTX 4090 环境下的自报测试结果,展示了不同方案在 90% 召回率下的表现差异:
- LEANN:存储 4 GB,NQ 检索耗时 2.48 秒,下游准确率 25.5%,完美适配 32 GB RAM 的工作站。
- HNSW (FAISS):存储 188 GB,NQ 检索耗时 0.05 秒,下游准确率 25.5%,在 32 GB RAM 环境下易发生内存溢出(OOM)。
- DiskANN:存储 270 GB,NQ 检索耗时 0.03 秒,适配 32 GB RAM 工作站。
- IVF-RECOMPUTE (EdgeRAG 风格):存储低于原始数据 5%,但 NQ 检索耗时高达 307.61 秒,实用性受限。
- PQ 压缩:存储 20 GB,但无法在测试中达到 90% 的召回率要求。
个人数据场景与工程化部署
LEANN 的设计初衷是将语义搜索与 RAG 能力下沉至个人设备。其开源仓库已提供针对多种个人数据源的现成应用支持,包括本地文档、Apple Mail、Chrome 浏览历史、微信、iMessage 以及主流 AI 助手的对话导出记录。
在工程集成方面,LEANN 具备以下特性:
- MCP 协议支持:可作为语义搜索 MCP 服务器直接接入 Claude Code 等智能体环境,并支持从 Slack 和 Twitter 书签拉取实时数据。
- 灵活的生成后端:支持对接 Ollama、Hugging Face、Anthropic 或任何兼容 OpenAI 格式的 API。
- 跨平台兼容:提供仅 CPU 的 Linux 安装选项,并全面支持 Ubuntu、Arch、WSL、macOS 和 Windows。部分特定应用(如 Apple Mail 搜索)则专为 macOS 优化。
通过 uv pip install leann 即可快速安装,代码采用宽松的 MIT 许可协议,为开发者在资源受限环境下构建本地化 RAG 应用提供了可靠的基础设施。
 LEANN