ARTEMIS
谷歌推出开源 Android 自动化项目 ARTEMIS,能够让 AI 助手、测试套件直接对安卓真机 / 模拟器进行拟人化操作,依靠自然语言指令完成跨应用测试与日常手机任务,在 AndroidWorld 多步任务基准评测中拿到 99% 以上的任务完成率。
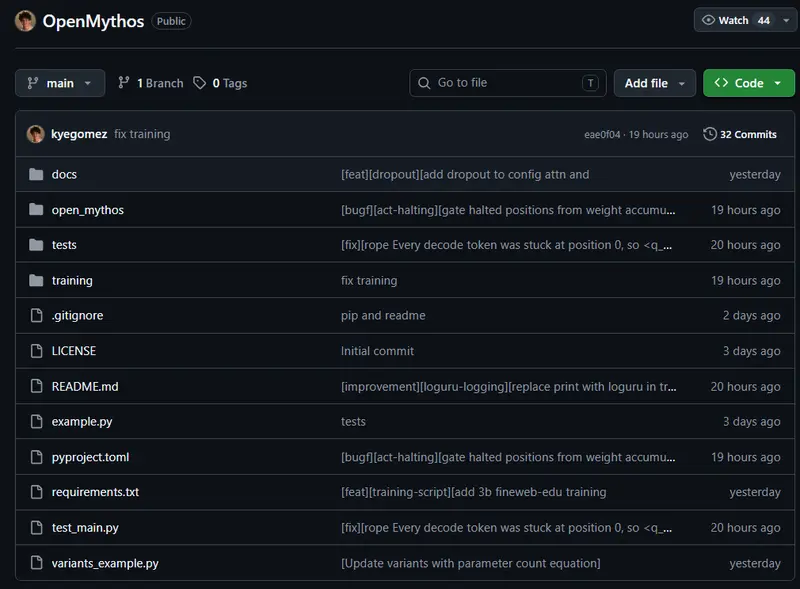
OpenMythos是一个开源的、基于第一性原理的 Claude Mythos 理论重构,使用 PyTorch 实现。该架构实例化了一个带有混合专家路由机制的循环变换器,通过权重共享和跨专家的条件计算实现迭代深度。
 OpenMythos
 是一个开源的、社区驱动的 PyTorch 实现,通过递归深度变换器 (Recurrent Deep Transformer, RDT) 架构来复现和探索 Anthropic Claude Mythos 模型的理论基础。
该项目的核心假设是:Mythos 并非传统的堆叠式 Transformer,而是一个通过权重共享和循环迭代在连续潜在空间中进行“静默思考”的模型。它结合了混合专家 (MoE) 机制,以极少的参数量实现了极高的推理深度和系统性泛化能力。
免责声明:OpenMythos 是基于公开研究和推测的独立理论重构,不与 Anthropic 官方关联。
OpenMythos 摒弃了传统的“层数堆叠”,转而采用时间换深度的策略。其架构分为三个阶段:
| 特性 | 传统 Transformer | OpenMythos (RDT) |
|---|---|---|
| 参数效率 | 质量随层数线性增长 | k 层参数达到 kL 层质量 |
| 推理扩展 | 固定深度 | 推理时增加循环次数即可加深思考 |
| 内存占用 | 随层数增加 | 恒定(权重共享) |
| 系统性泛化 | 较弱 | 强(通过相变涌现) |
| 训练稳定性 | 需精细调优 | LTI 约束保证鲁棒性 |
实证数据:在 7.7 亿参数下,RDT 在相同训练数据上匹配了 13 亿参数标准模型的性能。
pip install open-mythos
# 或使用 uv
uv pip install open-mythos
import torch
from open_mythos.main import OpenMythos, MythosConfig

# 配置模型
cfg = MythosConfig(
    vocab_size=1000,
    dim=256,
    n_heads=8,
    max_seq_len=128,
    max_loop_iters=4,      # 最大循环次数
    prelude_layers=1,
    coda_layers=1,
    n_experts=8,           # MoE 专家数
    n_shared_experts=1,
    attn_type="mla",       # 多潜在注意力
    kv_lora_rank=32,
    q_lora_rank=64,
)

# 初始化模型
model = OpenMythos(cfg)

# 前向传播
ids = torch.randint(0, cfg.vocab_size, (2, 16))
logits = model(ids, n_loops=4)  # 指定循环次数

# 生成文本
out = model.generate(ids, max_new_tokens=8, n_loops=8)

# 检查稳定性 (谱半径应 < 1)
A = model.recurrent.injection.get_A()
print(f"谱半径 ρ(A): {A.max().item():.4f}")
OpenMythos 提供了从 1B 到 1T 参数的预配置规模:
from open_mythos import mythos_7b, OpenMythos

cfg = mythos_7b()
model = OpenMythos(cfg)
| 变体 | 参数量级 | 循环次数 | 上下文窗口 |
|---|---|---|---|
mythos_1b | 1B | 16 | 4k |
mythos_7b | 7B | 16-24 | 8k |
mythos_100b | 100B | 32 | 1M |
mythos_1t | 1T | 64 | 1M |
项目提供了完整的训练脚本,支持单卡和多卡分布式训练。
# 单 GPU 训练 3B 模型
python training/3b_fine_web_edu.py

# 多 GPU 训练 (自动检测设备数)
torchrun --nproc_per_node=$(python -c "import torch; print(torch.cuda.device_count())") \
    training/3b_fine_web_edu.py
训练细节: