Open Keep
Open Keep 是一款简洁、注重隐私的笔记应用,专为希望完全掌控自身数据的用户而设计。它不依赖 Google,不收集个人数据——只有您的笔记,存储方式和位置完全由您掌控。使用简洁强大的 Markdown (.md) 格式编写笔记,通过密码保护/生物识别技术保护敏感内容,并使用您首选的云存储服务商,让所有内容在您的设备间保持同步。
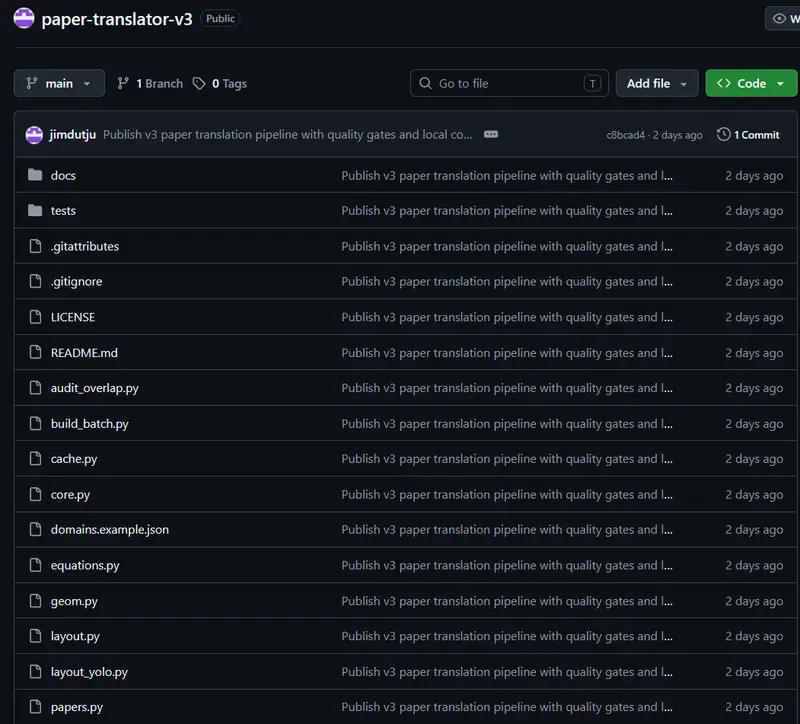
Paper Translator v3 是一套偏向学术、金融计量场景的PDF翻译管线,最大亮点是扫描件也能靠VLM识别+DocLayout-YOLO版面分割,公式走LaTeX矢量渲染,区别于纯文字层方案;缺点是依赖两套大模型API、LaTeX环境,还有跨栏、漏识别等实验阶段问题,适合愿意搭环境做论文本地化、有自定义提示词需求的用户。
 Paper Translator v3
 是一款面向扫描版与原生文字版学术论文的英文至中文 PDF 翻译实验管线。当前其主要验证样本集中于量化金融和计量经济学领域。该管线通过结合多模态视觉模型与传统的版面分析技术,致力于在翻译过程中实现中文正文的重新排版、公式的矢量化编译以及图表的原样保留,为学术文献的本地化阅读提供了一种高保真的探索方案。
Paper Translator v3 摒弃了单纯依赖 PDF 文本层的传统翻译方式,采用了一套混合解析策略:
DocLayout-YOLO 模型精准提取文档的版面边界框(Bounding Boxes),为后续的排版重建提供空间依据。pdflatex) 编译为高质量的矢量内容;图表区域则直接保留原图,确保视觉信息的完整性。作为一个本地运行的实验项目,v3 对环境配置有较为严格的要求,已在 Windows 10 / Python 3.13 环境下验证(建议 Python 3.11–3.13):
PyMuPDF、NumPy、PyYAML 及 doclayout-yolo。pdflatex 可用,并安装 amsmath、amssymb 等必要宏包。DEEPSEEK_API_KEY、TR_VISION_URL)配置,而非硬编码。命令行支持灵活的调用方式,例如指定领域、控制并行数或进行空运行测试:
python translate.py D:\papers -j 2 -o output --domain '量化金融与计量经济学'
为了确保翻译管线的稳定性与可追溯性,Paper Translator v3 内置了严格的质量控制机制:
开发者明确指出,Paper Translator v3 仍是一个可运行的实验项目,未进行完整的语义评测,也不声称整体性能优于成熟的 pdf2zh。用户在使用时需了解以下未解决的边界问题: